Databricks-Certified-Professional-Data-Engineer 문제 31
두 명의 데이터 엔지니어가 서로 다른 브랜치에서 동일한 Databricks 노트북을 작업하고 있습니다. 두 엔지니어 모두 동일한 코드 섹션을 수정했습니다. 한 엔지니어가 Databricks Git 폴더 UI를 사용하여 다른 엔지니어의 브랜치를 자신의 브랜치로 병합하려고 하면 해당 노트북 파일에서 병합 충돌이 발생합니다. UI는 충돌을 강조 표시하고 해결 옵션을 제시합니다.
데이터 엔지니어는 Databricks Git 폴더를 사용하여 이 병합 충돌을 어떻게 해결해야 할까요?
데이터 엔지니어는 Databricks Git 폴더를 사용하여 이 병합 충돌을 어떻게 해결해야 할까요?
Databricks-Certified-Professional-Data-Engineer 문제 32
데이터 엔지니어가 Lakeflow Declarative Pipelines의 Expectations 기능을 사용하여 수신되는 센서 데이터의 품질을 추적하고 있습니다. 센서에서 주기적으로 범위를 벗어난 잘못된 측정값이 전송되는데, 현재는 해당 행에 경고 플래그를 지정하고 정상 데이터와 함께 실버 테이블에 기록하고 있습니다. 그런데 새로운 요구 사항이 생겼습니다. 잘못된 행을 별도의 격리 테이블에 저장하고 더 이상 실버 테이블에 포함시키지 않아야 한다는 것입니다.
이것은 그들의 은색 테이블에 대한 기존 코드입니다:
@dlt.table
@dlt.expect( " valid_sensor_reading " , " reading < 120 " )
def silver_sensor_readings():
spark.readStream.table(" bronze_sensor_readings " )를 반환합니다.
어떤 코드가 요구 사항을 충족할까요?
이것은 그들의 은색 테이블에 대한 기존 코드입니다:
@dlt.table
@dlt.expect( " valid_sensor_reading " , " reading < 120 " )
def silver_sensor_readings():
spark.readStream.table(" bronze_sensor_readings " )를 반환합니다.
어떤 코드가 요구 사항을 충족할까요?
Databricks-Certified-Professional-Data-Engineer 문제 33
Databricks 작업이 3개의 태스크로 구성되었으며, 각 태스크는 Databricks 노트북입니다. 태스크 A는 다른 태스크에 종속되지 않습니다. 태스크 B와 C는 병렬로 실행되며, 각각 태스크 A에 직렬 종속성을 갖습니다.
작업 A가 예정된 실행 중에 실패할 경우, 이 실행 결과를 설명하는 문장은 무엇입니까?
작업 A가 예정된 실행 중에 실패할 경우, 이 실행 결과를 설명하는 문장은 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 34
데이터 엔지니어링 팀은 기존 데이터 파이프라인을 Auto Loader를 활용하도록 전환하는 작업을 진행 중입니다.
JSON 파일 수집 시 점진적 처리가 이루어지고 있습니다. 한 데이터 엔지니어가 다음과 같은 코드를 발견했습니다.
자동 로더 문서의 블록:
1. (streaming_df = spark.readStream.format("cloudFiles")
2. .option("cloudFiles.format", "json")
3. .option("cloudFiles.schemaLocation", schemaLocation)
4. .load(sourcePath))
schemaLocation과 sourcePath가 올바르게 설정되었다고 가정할 때, 다음 중 어떤 변경 사항이 영향을 미칩니까?
데이터 엔지니어는 이 코드 블록을 자동 로더를 사용하여 데이터를 수집하도록 변환해야 합니까?
Databricks-Certified-Professional-Data-Engineer 문제 35
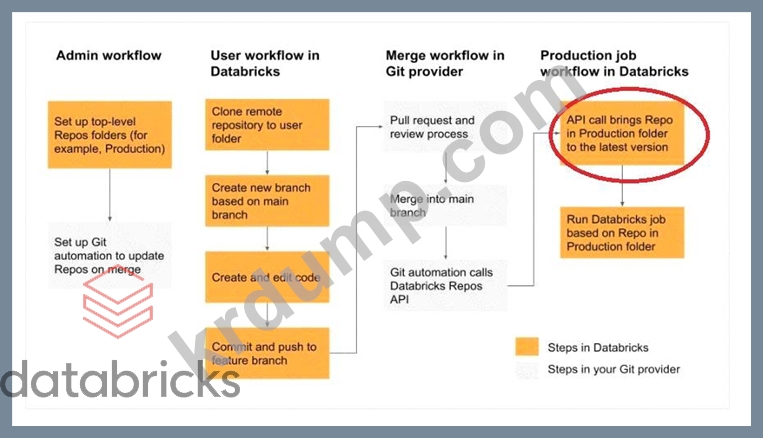
CI/CD 흐름에서 다음 중 어떤 개발자 작업을 Databricks 리포지토리에서 구현할 수 있습니까?