
Databricks-Certified-Professional-Data-Engineer 문제 51
Databricks SQL 쿼리 실행 속도가 느리다는 것을 발견했습니다. 쿼리 실행 속도가 느린 원인을 파악하고 성능 향상 방안을 마련해야 합니다. 문제를 확인한 결과 모든 쿼리가 병렬로 실행되고 있으며 단일 클러스터의 SQL 엔드포인트(SQL Warehouse)를 사용하고 있음을 알게 되었습니다. 다음 중 쿼리 성능/응답 시간을 개선하기 위해 취할 수 있는 조치는 무엇입니까?
*참고로 Databricks는 최근 SQL 엔드포인트의 이름을 SQL 웨어하우스로 변경했습니다.
*참고로 Databricks는 최근 SQL 엔드포인트의 이름을 SQL 웨어하우스로 변경했습니다.


Databricks-Certified-Professional-Data-Engineer 문제 52
다음 로직을 사용하여 activity_details라는 Delta 테이블에 CHECK 제약 조건이 성공적으로 추가되었습니다.
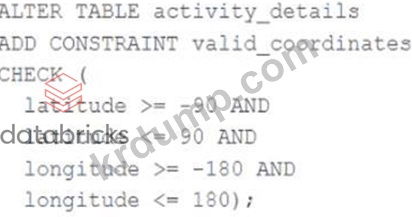
배치 작업이 테이블에 새 레코드를 삽입하려고 시도하고 있으며, 여기에는 위도 = 45.50, 경도 = 212.67인 레코드가 포함됩니다.
다음 중 이 일괄 삽입 작업의 결과를 가장 잘 설명하는 문장은 무엇입니까?
배치 작업이 테이블에 새 레코드를 삽입하려고 시도하고 있으며, 여기에는 위도 = 45.50, 경도 = 212.67인 레코드가 포함됩니다.
다음 중 이 일괄 삽입 작업의 결과를 가장 잘 설명하는 문장은 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 53
사용자는 DLT 기대치를 사용하여 파생 테이블 보고서에 원본의 모든 레코드가 포함되어 있는지, 그리고 테이블 validation_copy에 포함된 레코드가 있는지 검증하려고 합니다.
사용자는 보고서 테이블 정의에 기대값을 추가하는 방식으로 이를 시도했지만 실패했습니다.
DLT 기대값을 사용하여 이 테이블에 예상되는 모든 레코드가 있는지 검증할 수 있는 접근 방식은 무엇일까요?
사용자는 보고서 테이블 정의에 기대값을 추가하는 방식으로 이를 시도했지만 실패했습니다.
DLT 기대값을 사용하여 이 테이블에 예상되는 모든 레코드가 있는지 검증할 수 있는 접근 방식은 무엇일까요?
Databricks-Certified-Professional-Data-Engineer 문제 54
다음 오류 추적(display(df.select(3* " heartrate " )))에서 AnalysisException: cannot resolve ' heartrateheartrateheartrate '이 표시됨)이 나타났을 때, 발생한 오류를 설명하는 문장은 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 55
데이터 설계자는 레이크하우스의 모든 테이블을 외부 Delta Lake 테이블로 구성해야 한다고 지시했습니다.
어떤 접근 방식이 이 요구 사항을 충족시킬 수 있을까요?
어떤 접근 방식이 이 요구 사항을 충족시킬 수 있을까요?