
Databricks-Certified-Professional-Data-Engineer 문제 21
문제 26. 5000개의 서로 다른 색깔의 공이 있는데, 그중 1200개가 분홍색입니다. 이 중 최댓값은 얼마입니까?
색깔 공 테스트 세트에서 "분홍색" 항목이 차지하는 비율에 대한 가능성 추정치는 얼마입니까?
색깔 공 테스트 세트에서 "분홍색" 항목이 차지하는 비율에 대한 가능성 추정치는 얼마입니까?
Databricks-Certified-Professional-Data-Engineer 문제 22
데이터 관리팀은 GDPR 준수를 위해 사용자 기록 삭제를 검토하고 있습니다. 사용자 조회 테이블에서 사용자 집계 테이블로 삭제 요청을 반영하기 위해 다음과 같은 로직이 구현되었습니다.
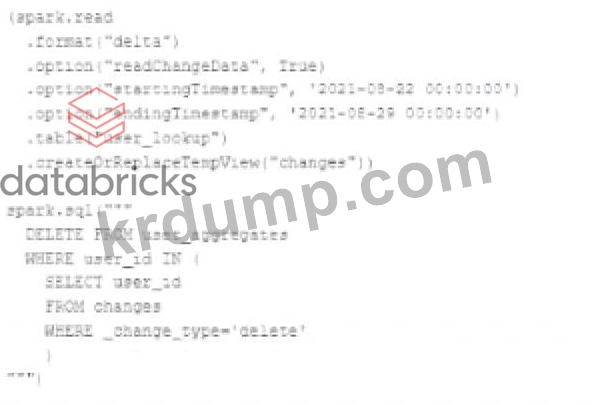
user_id가 고유 식별 키이고 삭제를 요청한 모든 사용자가 user_lookup 테이블에서 제거되었다고 가정할 때, 위의 로직을 성공적으로 실행하면 user_aggregates 테이블에서 삭제될 레코드에 더 이상 접근할 수 없게 된다는 것을 보장하는지 여부를 설명하는 문장은 무엇이며, 그 이유는 무엇입니까?
user_id가 고유 식별 키이고 삭제를 요청한 모든 사용자가 user_lookup 테이블에서 제거되었다고 가정할 때, 위의 로직을 성공적으로 실행하면 user_aggregates 테이블에서 삭제될 레코드에 더 이상 접근할 수 없게 된다는 것을 보장하는지 여부를 설명하는 문장은 무엇이며, 그 이유는 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 23
머신러닝 팀은 델타 레이크 레이크하우스에 있는 CDF(Change Data Feed)가 활성화된 customer_churn_params 테이블을 이탈 예측에 사용합니다. 이 테이블에는 여러 상위 소스에서 가져온 고객 정보가 포함되어 있습니다. 현재 데이터 엔지니어링 팀은 상위 데이터 소스에서 가져온 최신 유효 값으로 테이블을 덮어쓰는 방식으로 매일 밤 이 테이블을 업데이트하고 있습니다. 머신러닝 팀에서 사용하는 이탈 예측 모델은 프로덕션 환경에서 상당히 안정적입니다. 팀은 지난 24시간 동안 변경된 레코드에 대해서만 예측을 수행하는 데 관심이 있습니다. 이러한 변경된 레코드를 더 쉽게 식별할 수 있는 접근 방식은 무엇일까요?
Databricks-Certified-Professional-Data-Engineer 문제 24
3개의 실행 노드로 구성된 특정 클러스터의 Ganglia 메트릭을 평가할 때, 어떤 지표가 VM 리소스의 적절한 활용을 나타낼까요?
Databricks-Certified-Professional-Data-Engineer 문제 25
시간 단위 배치 작업이 구성되어 클라우드 객체 스토리지 컨테이너에서 데이터 파일을 수집합니다. 각 배치는 해당 시간 동안 소스 시스템에서 생성된 모든 레코드를 나타냅니다. 이러한 레코드를 레이크하우스에 처리하는 배치 작업은 지연된 데이터가 누락되지 않도록 충분한 시간 간격을 두고 실행됩니다. `user_id` 필드는 데이터의 고유 키를 나타내며, 다음과 같은 스키마를 가집니다.
user_id는 BIGINT, username은 STRING, user_utc는 STRING, user_region은 STRING, last_login은 BIGINT, auto_pay는 BOOLEAN, last_updated는 BIGINT입니다. 모든 새 레코드는 account_history라는 테이블에 입력되며, 이 테이블은 소스와 동일한 스키마에 모든 데이터의 전체 기록을 유지합니다. 시스템의 다음 테이블은 account_current이며, 각 고유 user_id에 대한 최신 값을 나타내는 Type 1 테이블로 구현됩니다.
수백만 개의 사용자 계정과 시간당 수만 건의 레코드가 처리된다고 가정할 때, 매시간 배치 작업의 일부로 describedaccount_currenttable을 효율적으로 업데이트하는 데 사용할 수 있는 구현 방법은 무엇입니까?