
Databricks-Certified-Professional-Data-Engineer 문제 41
Databricks를 처음 사용하는 사용자가 작업 중인 파이프라인 로직의 실행 시간이 너무 오래 걸리는 문제를 해결하려고 합니다. 현재 사용자는 코드를 셀 단위로 실행하면서 display() 호출을 통해 새로운 변환이 작업에 추가될 때 코드가 논리적으로 올바른 결과를 생성하는지 확인하고 있습니다. 평균 실행 시간을 측정하기 위해 각 셀을 대화형으로 여러 번 실행하고 있습니다.
다음 중 어떤 조정을 하면 실제 운영 환경에서 코드 성능을 더 정확하게 측정할 수 있을까요?
다음 중 어떤 조정을 하면 실제 운영 환경에서 코드 성능을 더 정확하게 측정할 수 있을까요?
Databricks-Certified-Professional-Data-Engineer 문제 42
데이터 엔지니어링 팀은 수천 개의 테이블과 뷰로 구성된 엔터프라이즈 시스템을 레이크하우스로 마이그레이션하고 있습니다. 이들은 브론즈, 실버, 골드 테이블 계층 구조를 사용하여 목표 아키텍처를 구현할 계획입니다. 브론즈 테이블은 주로 프로덕션 데이터 엔지니어링 워크로드에 사용되고, 실버 테이블은 데이터 엔지니어링 및 머신 러닝 워크로드를 모두 지원하는 데 사용됩니다. 골드 테이블은 주로 비즈니스 인텔리전스 및 보고 목적으로 사용됩니다. 모든 데이터 계층에 개인 식별 정보(PII)가 존재하지만, 실버 및 골드 계층의 모든 데이터에는 가명화 및 익명화 규칙이 적용됩니다.
해당 조직은 다양한 팀 간의 협업 능력을 극대화하면서 보안 문제를 줄이는 데 관심이 있습니다.
다음 중 이 시스템 구현을 위한 모범 사례를 보여주는 문장은 무엇입니까?
해당 조직은 다양한 팀 간의 협업 능력을 극대화하면서 보안 문제를 줄이는 데 관심이 있습니다.
다음 중 이 시스템 구현을 위한 모범 사례를 보여주는 문장은 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 43
태스크 오케스트레이터가 한 시간 간격으로 두 개의 작업을 실행하도록 구성되었습니다. 첫 번째 작업은 외부 시스템에서 Parquet 데이터를 /mnt/raw_orders/에 마운트된 디렉터리에 기록하는 것입니다. 이 데이터가 기록된 후, 다음 코드가 포함된 Databricks 작업이 실행됩니다.
(스파크.리드스트림)
.format( " parquet " )
.load( " /mnt/raw_orders/ " )
.withWatermark( "시간 " , "2시간 " )
.dropDuplicates([ " customer_id " , " order_id " ])
.writeStream
.트리거(once=True)
.table( " 주문 " )
)
customer_id와 order_id 필드가 각 주문을 고유하게 식별하는 복합 키 역할을 하고, time 필드는 소스 시스템에서 레코드가 대기열에 추가된 시간을 나타낸다고 가정합니다. 상위 시스템에서 단일 주문에 대해 몇 시간 간격으로 중복 항목이 대기열에 추가되는 경우가 있는 것으로 알려져 있다면, 다음 중 어떤 설명이 정확합니까?
Databricks-Certified-Professional-Data-Engineer 문제 44
야간 작업은 다음 코드를 사용하여 Delta Lake 테이블에 데이터를 수집합니다.
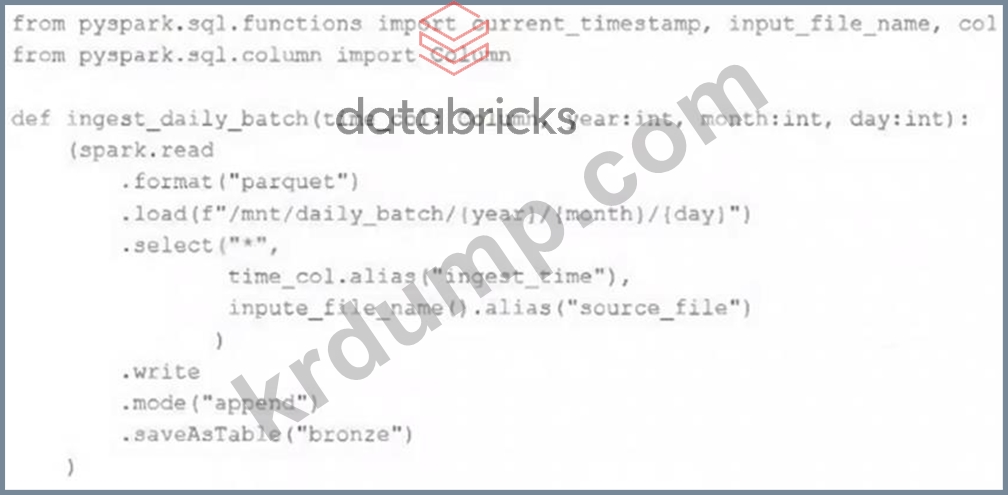
파이프라인의 다음 단계에서는 파이프라인의 다음 테이블로 아직 처리되지 않은 새 레코드를 조작하는 데 사용할 수 있는 객체를 반환하는 함수가 필요합니다.
다음 코드 조각 중 어떤 것이 이 함수 정의를 완성합니까?
def new_records():
파이프라인의 다음 단계에서는 파이프라인의 다음 테이블로 아직 처리되지 않은 새 레코드를 조작하는 데 사용할 수 있는 객체를 반환하는 함수가 필요합니다.
다음 코드 조각 중 어떤 것이 이 함수 정의를 완성합니까?
def new_records():
Databricks-Certified-Professional-Data-Engineer 문제 45
팀원이 델타 파이프라인을 설정하고 기존 Delta Live 테이블인 sales_orders_cleaned를 기반으로 집계된 메트릭을 사용하여 동일한 파이프라인에 두 번째 골드 테이블을 구축하려고 하는데, 파이프라인 시작 시 sales_orders_cleaned 테이블을 찾을 수 없다는 오류가 발생하여 실패하고 있습니다. 이 문제를 파악하고 해결해 주시기 바랍니다.
1. sales_order_in_chicago라는 라이브 테이블을 생성합니다.
2.AS
3.SELECT order_date, city, sum(price) as sales,
4. 판매 주문 정리됨에서
5. 여기서 city = '시카고')
6. 주문일과 도시를 기준으로 그룹화
1. sales_order_in_chicago라는 라이브 테이블을 생성합니다.
2.AS
3.SELECT order_date, city, sum(price) as sales,
4. 판매 주문 정리됨에서
5. 여기서 city = '시카고')
6. 주문일과 도시를 기준으로 그룹화