
Databricks-Certified-Professional-Data-Engineer 문제 26
데이터 엔지니어가 대규모 ETL 파이프라인을 위해 Databricks CLI를 사용하여 클러스터를 생성하려고 합니다. 이 클러스터는 워커 5개, i3.xlarge 드라이버 1개, 그리고 '14.3.x-scala2.12' 런타임을 사용해야 합니다.
데이터 엔지니어는 어떤 명령어를 사용해야 할까요?
데이터 엔지니어는 어떤 명령어를 사용해야 할까요?
Databricks-Certified-Professional-Data-Engineer 문제 27
팀의 주니어 데이터 엔지니어가 다음 코드 블록을 구현했습니다.
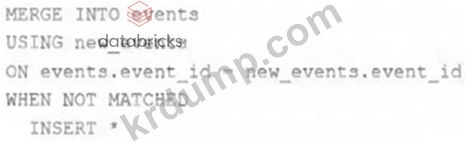
뷰 `new_events`에는 `events Delta` 테이블과 동일한 스키마를 가진 레코드 배치가 포함되어 있습니다. `event_id` 필드는 이 테이블의 고유 키 역할을 합니다.
이 쿼리가 실행될 때, 기존 레코드와 동일한 event_id를 가진 새 레코드는 어떻게 처리됩니까?
뷰 `new_events`에는 `events Delta` 테이블과 동일한 스키마를 가진 레코드 배치가 포함되어 있습니다. `event_id` 필드는 이 테이블의 고유 키 역할을 합니다.
이 쿼리가 실행될 때, 기존 레코드와 동일한 event_id를 가진 새 레코드는 어떻게 처리됩니까?
Databricks-Certified-Professional-Data-Engineer 문제 28
거의 실시간에 가까운 워크로드를 처리하기 위해 데이터 엔지니어가 Databricks Auto Loader의 스키마 감지 및 진화 기능을 활용하는 헬퍼 함수를 개발하고 있습니다. 이 함수는 소스의 스키마를 자동으로 감지하고, 소스 디렉터리에 JSON 파일이 도착하는 즉시 점진적으로 처리하며, 새 필드가 감지되면 테이블의 스키마를 자동으로 진화시킵니다.
함수는 아래와 같이 공백으로 표시됩니다.

다음 보기 중 주어진 요건을 충족하는 빈칸에 맞는 정답은 무엇입니까?

함수는 아래와 같이 공백으로 표시됩니다.
다음 보기 중 주어진 요건을 충족하는 빈칸에 맞는 정답은 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 29
데이터 엔지니어링 팀은 현재 매일 오전 8시에 보고 테이블에 데이터를 로드하는 작업을 실행하도록 설정되어 있으며, 이 작업은 약 20분 정도 소요됩니다. 운영 팀은 이 데이터를 사용하여 두 번째 작업을 실행하고 최신 전체 데이터 세트에 접근할 계획입니다. 이러한 작업 설정을 효율적으로 관리하는 가장 좋은 방법은 무엇일까요?


Databricks-Certified-Professional-Data-Engineer 문제 30
CI/CD 흐름에서 다음 중 어떤 개발자 작업을 Databricks 리포지토리에서 구현할 수 있습니까?
