
Databricks-Certified-Professional-Data-Engineer 문제 46
다음 코드는 기존 워크로드에서 Databricks 노트북으로 마이그레이션되었습니다.

코드는 성공적으로 실행되어 논리적으로 올바른 결과를 제공하지만, 약 1GB의 데이터를 추출하고 불러오는 데 20분 이상이 소요됩니다.
다음 중 이러한 행동에 대한 가능한 설명은 무엇입니까?
코드는 성공적으로 실행되어 논리적으로 올바른 결과를 제공하지만, 약 1GB의 데이터를 추출하고 불러오는 데 20분 이상이 소요됩니다.
다음 중 이러한 행동에 대한 가능한 설명은 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 47
상위 소스는 Parquet 데이터를 시간 단위로 현재 날짜로 명명된 디렉터리에 배치 형식으로 저장합니다. 야간 배치 작업은 날짜 변수에 지정된 날짜의 전날 데이터를 모두 가져오기 위해 다음 코드를 실행합니다.
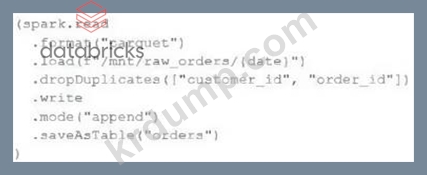
customer_id와 order_id 필드가 각 주문을 고유하게 식별하는 복합 키 역할을 한다고 가정합니다.
상위 시스템에서 단일 주문에 대해 몇 시간 간격으로 중복 항목이 생성되는 경우가 있는 것으로 알려져 있다면, 다음 중 어떤 설명이 맞습니까?
customer_id와 order_id 필드가 각 주문을 고유하게 식별하는 복합 키 역할을 한다고 가정합니다.
상위 시스템에서 단일 주문에 대해 몇 시간 간격으로 중복 항목이 생성되는 경우가 있는 것으로 알려져 있다면, 다음 중 어떤 설명이 맞습니까?
Databricks-Certified-Professional-Data-Engineer 문제 48
데이터 엔지니어가 고객이 대여 자전거를 사용하는 위치를 파악하기 위한 데이터 수집 파이프라인을 구축하고 있습니다. 엔지니어는 시간이 지남에 따라 자전거 센서에서 전송되는 데이터에 위도와 경도 같은 중요한 세부 정보가 누락되는 것을 발견했습니다. 하위 단계의 분석가들은 별도의 처리를 위해 깨끗한 데이터와 누락된 데이터를 모두 필요로 합니다.
데이터 엔지니어는 이미 이 코드를 가지고 있습니다.
dlt를 가져옵니다
pyspark.sql.functions에서 expr을 가져옵니다.
규칙 = {
" valid_lat " : " (lat IS NOT NULL) " ,
" valid_long " : " (long은 NULL이 아닙니다) "
}
quarantine_rules = " NOT({0})" .format( " AND " .join(rules.values()))
@dlt.view
def raw_trips_data():
spark.readStream.table(" ride_and_go.telemetry.trips ")를 반환합니다.
데이터 엔지니어는 양질의 데이터와 불량 데이터를 구분하기 위한 요구 사항을 어떻게 충족해야 할까요?
Databricks-Certified-Professional-Data-Engineer 문제 49
멀티태스킹 작업에서 태스크로 실행되도록 구성된 노트북을 검토하는 데 사용할 수 있는 REST API 호출은 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 50
프로덕션 환경에 배포된 구조화된 스트리밍 작업이 하루 중 사용량이 많은 시간대에 지연 현상을 보이고 있습니다. 현재 정상적인 실행 시에는 각 마이크로배치 데이터 처리 시간이 3초 미만입니다. 하지만 사용량이 많은 시간대에는 각 마이크로배치의 처리 시간이 매우 불규칙해지며, 때로는 3초를 초과하기도 합니다.
30초. 스트리밍 쓰기는 현재 10초의 트리거 간격으로 구성되어 있습니다.
다른 모든 변수를 일정하게 유지하고 레코드를 10초 이내에 처리해야 한다고 가정할 때, 어떤 조정이 요구 사항을 충족할까요?
30초. 스트리밍 쓰기는 현재 10초의 트리거 간격으로 구성되어 있습니다.
다른 모든 변수를 일정하게 유지하고 레코드를 10초 이내에 처리해야 한다고 가정할 때, 어떤 조정이 요구 사항을 충족할까요?