
Databricks-Certified-Data-Engineer-Professional-KR 문제 81
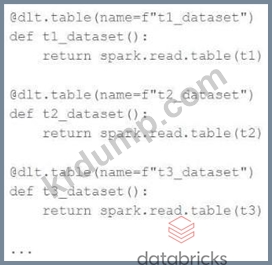
데이터 엔지니어는 코드가 매우 유사한 여러 테이블 정의를 포함하는 다음 DLT 코드를 리팩토링하려고 합니다.
데이터 엔지니어는 매개변수화된 테이블 정의를 사용하여 이러한 테이블을 프로그래밍 방식으로 생성하기 위해 다음과 같은 코드를 작성했습니다.
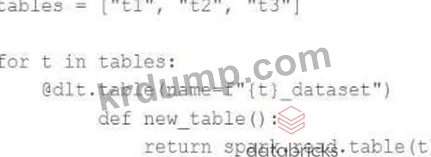
파이프라인은 리팩토링된 코드를 사용하여 업데이트를 실행하지만, 이러한 테이블에 대해 잘못된 구성 값을 보여주는 다른 DAG를 생성합니다.
데이터 엔지니어는 이 문제를 어떻게 해결할 수 있을까요?
데이터 엔지니어는 매개변수화된 테이블 정의를 사용하여 이러한 테이블을 프로그래밍 방식으로 생성하기 위해 다음과 같은 코드를 작성했습니다.
파이프라인은 리팩토링된 코드를 사용하여 업데이트를 실행하지만, 이러한 테이블에 대해 잘못된 구성 값을 보여주는 다른 DAG를 생성합니다.
데이터 엔지니어는 이 문제를 어떻게 해결할 수 있을까요?
Databricks-Certified-Data-Engineer-Professional-KR 문제 82
데이터 엔지니어링 팀은 고객 데이터 삭제(잊혀질 만한 데이터) 요청을 처리하는 작업을 구성했습니다. 삭제해야 할 모든 사용자 데이터는 기본 테이블 설정을 사용하여 Delta Lake 테이블에 저장됩니다.
팀은 지난주 삭제된 모든 데이터를 매주 일요일 새벽 1시에 일괄 처리하기로 결정했습니다. 이 작업의 총 소요 시간은 1시간 미만입니다. 또한 매주 월요일 새벽 3시에는 일괄 작업이 조직 전체의 Delta Lake 테이블에 대해 일련의 VACUUM 명령을 실행합니다.
준법감시 담당자는 최근 Delta Lake의 타임 트래블 기능에 대해 알게 되었습니다. 담당자는 이 기능으로 인해 삭제된 데이터에 계속 접근할 수 있을 가능성을 우려하고 있습니다.
모든 삭제 로직이 올바르게 구현되었다고 가정할 때, 다음 중 이 문제를 정확하게 해결하는 문장은 무엇입니까?
팀은 지난주 삭제된 모든 데이터를 매주 일요일 새벽 1시에 일괄 처리하기로 결정했습니다. 이 작업의 총 소요 시간은 1시간 미만입니다. 또한 매주 월요일 새벽 3시에는 일괄 작업이 조직 전체의 Delta Lake 테이블에 대해 일련의 VACUUM 명령을 실행합니다.
준법감시 담당자는 최근 Delta Lake의 타임 트래블 기능에 대해 알게 되었습니다. 담당자는 이 기능으로 인해 삭제된 데이터에 계속 접근할 수 있을 가능성을 우려하고 있습니다.
모든 삭제 로직이 올바르게 구현되었다고 가정할 때, 다음 중 이 문제를 정확하게 해결하는 문장은 무엇입니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 83
데이터 과학 팀은 MLflow를 사용하여 프로덕션 모델을 생성하고 로그에 기록했습니다. 다음 코드는 프로덕션 모델을 올바르게 가져와 적용하여 "customer_id LONG, predictions DOUBLE, date DATE" 스키마를 가진 preds라는 새 DataFrame으로 예측 결과를 출력합니다.
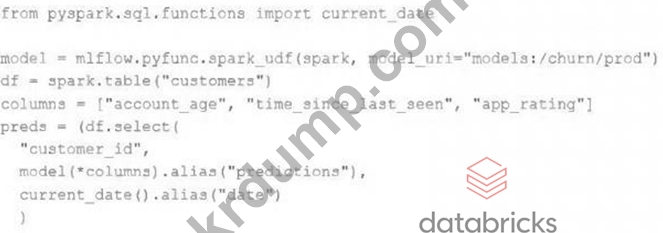
데이터 과학 팀은 예측 결과를 Delta Lake 테이블에 저장하고, 시간 경과에 따른 모든 예측 결과를 비교할 수 있기를 원합니다. 고객 이탈 예측은 하루에 최대 한 번만 수행됩니다.
어떤 코드 블록이 잠재적인 컴퓨팅 비용을 최소화하면서 이 작업을 수행합니까?
데이터 과학 팀은 예측 결과를 Delta Lake 테이블에 저장하고, 시간 경과에 따른 모든 예측 결과를 비교할 수 있기를 원합니다. 고객 이탈 예측은 하루에 최대 한 번만 수행됩니다.
어떤 코드 블록이 잠재적인 컴퓨팅 비용을 최소화하면서 이 작업을 수행합니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 84
데이터 엔지니어가 프로덕션 데이터셋의 일부를 샌드박스 환경으로 복사하는 PySpark 코드를 검토하면서 개인 식별 정보(PII)가 복사되지 않는지 확인해야 합니다. 판매 테이블을 확인한 결과, 사용자 이메일이 유일한 PII 데이터이며 사용자를 식별하는 유일한 열이라는 것을 발견했습니다.
pyspark.sql에서 함수를 F로 가져옵니다.
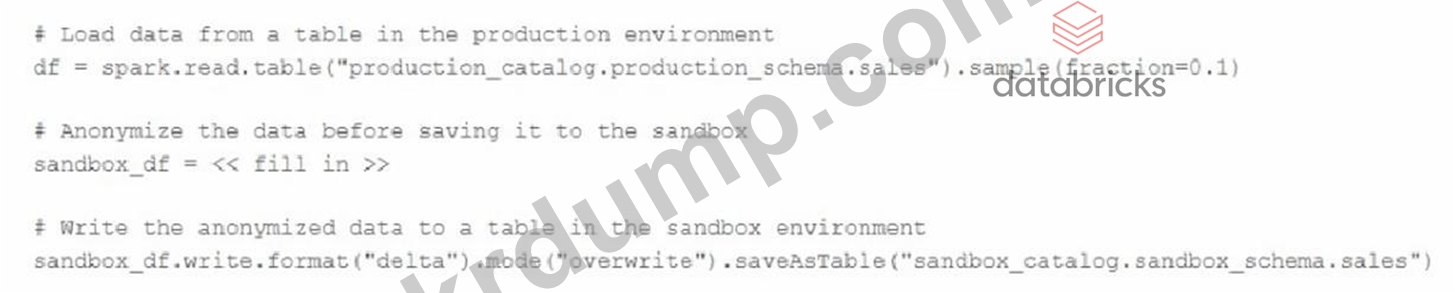
원하는 결과를 얻으려면 어떤 익명화 코드를 사용해야 할까요?
pyspark.sql에서 함수를 F로 가져옵니다.
원하는 결과를 얻으려면 어떤 익명화 코드를 사용해야 할까요?
Databricks-Certified-Data-Engineer-Professional-KR 문제 85
데이터 엔지니어가 여러 수학 함수를 테스트하고 있는데, 그중 하나는 다른 함수가 설명한 대로 곡선 아래 면적을 계산하는 함수입니다.
assert(myIntegrate(lambda x: x*x, 0, 3) [0] == 9)
위 문장은 어떤 유형의 시험을 예시하는가?
assert(myIntegrate(lambda x: x*x, 0, 3) [0] == 9)
위 문장은 어떤 유형의 시험을 예시하는가?