
Databricks-Certified-Data-Engineer-Professional-KR 문제 76
데이터 엔지니어가 Databricks에 있는 대규모 분할 소매 데이터 세트를 분석하고 있습니다. 각 행은 영업 사원이 수행한 판매를 나타냅니다. 이 데이터 세트는 다음과 같은 스키마를 가진 수백만 개의 레코드로 구성되어 있습니다.
sales_df: [salesperson_id: string, region: string, sale_amount: double, sale_date: date] 데이터 엔지니어는 각 지역 내 영업 사원들의 누적 총 판매액을 기준으로 순위를 매기는 데이터프레임을 생성해야 합니다. 가장 높은 판매액을 기록한 영업 사원을 1위로 지정합니다. 여러 영업 사원의 누적 판매액이 같을 경우, 동일한 순위를 부여해야 합니다.
데이터 엔지니어는 PySpark의 윈도우 함수와 dense_rank() 함수를 사용하여 이 로직을 구현하려고 합니다.
어떤 코드 조각이 이러한 순위 매기기를 수행할까요?
sales_df: [salesperson_id: string, region: string, sale_amount: double, sale_date: date] 데이터 엔지니어는 각 지역 내 영업 사원들의 누적 총 판매액을 기준으로 순위를 매기는 데이터프레임을 생성해야 합니다. 가장 높은 판매액을 기록한 영업 사원을 1위로 지정합니다. 여러 영업 사원의 누적 판매액이 같을 경우, 동일한 순위를 부여해야 합니다.
데이터 엔지니어는 PySpark의 윈도우 함수와 dense_rank() 함수를 사용하여 이 로직을 구현하려고 합니다.
어떤 코드 조각이 이러한 순위 매기기를 수행할까요?
Databricks-Certified-Data-Engineer-Professional-KR 문제 77
데이터 팀의 구조화된 스트리밍 작업은 하위 마케팅 대시보드를 업데이트하기 위해 품목 판매량에 대한 집계 데이터를 계산하도록 구성되어 있습니다. 마케팅 팀은 각 품목에 대해 해당 프로모션 코드가 사용된 횟수를 추적하기 위한 새로운 필드를 추가했습니다. 주니어 데이터 엔지니어는 기존 쿼리를 다음과 같이 업데이트할 것을 제안했습니다. 제안된 변경 사항은 굵게 표시되어 있습니다.
원래 검색어:

제안된 질의:

제안된 쿼리를 실제 운영 환경에 적용하려면 어떤 단계를 추가로 완료해야 합니까?
원래 검색어:
제안된 질의:
제안된 쿼리를 실제 운영 환경에 적용하려면 어떤 단계를 추가로 완료해야 합니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 78
프로덕션 데이터에 대한 의도치 않은 커밋을 방지하기 위해, 선임 데이터 엔지니어는 모든 개발 작업에서 Delta Lake 테이블의 클론을 참조하도록 하는 정책을 수립했습니다. 심층 클론과 얕은 클론 방식을 모두 테스트한 후, 얕은 클론 방식을 사용하여 개발 테이블을 생성했습니다. 최초 테이블 생성 후 몇 주가 지나자, Type 1 Slowly Changing Dimension(SCD)으로 구현된 여러 테이블의 클론 버전이 작동을 멈췄습니다. 원본 테이블의 트랜잭션 로그를 확인해 보니 전날 vacuum 작업이 실행된 것으로 나타났습니다.
복제된 테이블이 더 이상 작동하지 않는 이유는 무엇입니까?
복제된 테이블이 더 이상 작동하지 않는 이유는 무엇입니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 79
주니어 데이터 엔지니어가 Delta Lake의 변경 데이터 피드(Change Data Feed) 기능을 활용하여 `delta.enableChangeDataFeed = true` 속성으로 생성된 브론즈 테이블의 모든 행에 대해 유효했던 모든 값을 나타내는 유형 1 테이블을 생성하려고 합니다. 이 엔지니어는 다음 코드를 매일 실행할 계획입니다.
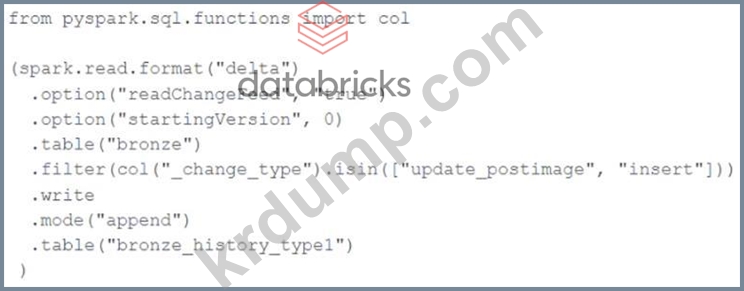
다음 중 위 쿼리를 여러 번 실행했을 때의 실행 과정과 결과를 가장 잘 설명하는 문장은 무엇입니까?
다음 중 위 쿼리를 여러 번 실행했을 때의 실행 과정과 결과를 가장 잘 설명하는 문장은 무엇입니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 80
현재 활성화된 클러스터의 모든 노드에 노트북 수준의 범위로 Python 패키지를 설치하는 방법은 무엇입니까?