
Databricks-Certified-Data-Engineer-Professional-KR 문제 96
대규모 데이터셋을 다루는 성능이 중요한 애플리케이션에서 기존 PySpark UDF보다 Pandas UDF가 선호되는 이유는 무엇일까요?
Databricks-Certified-Data-Engineer-Professional-KR 문제 97
데이터 엔지니어는 고객 거래 데이터를 처리하는 프로덕션 Lakeflow 선언적 파이프라인을 관리합니다. 이 파이프라인에는 transaction_amount > 0 및 customer_id IS NOT NULL과 같은 여러 데이터 품질 요구 사항이 포함되어 있습니다. 이러한 요구 사항은 SQL의 EXPECT 절을 사용하여 정의됩니다.
엔지니어는 최신 파이프라인 업데이트 중에 각 기대치를 충족하거나 충족하지 못한 레코드 수를 분석하여 파이프라인의 데이터 품질을 모니터링하는 것을 목표로 합니다. Lakeflow 선언적 파이프라인의 이벤트 로그는 event_log_table이라는 Delta 테이블에 저장됩니다.
최근 파이프라인 업데이트에 대해 각 기대치의 이름, 관련 데이터 세트, 기대치를 통과한 레코드 수, 기대치를 통과하지 못한 레코드 수와 같은 정보를 추출하는 데 적합한 프로그래밍 방식을 결정하십시오.
Lakeflow 선언적 파이프라인 이벤트 로그에서 원하는 데이터 품질 지표를 가져오는 메서드는 무엇입니까?
엔지니어는 최신 파이프라인 업데이트 중에 각 기대치를 충족하거나 충족하지 못한 레코드 수를 분석하여 파이프라인의 데이터 품질을 모니터링하는 것을 목표로 합니다. Lakeflow 선언적 파이프라인의 이벤트 로그는 event_log_table이라는 Delta 테이블에 저장됩니다.
최근 파이프라인 업데이트에 대해 각 기대치의 이름, 관련 데이터 세트, 기대치를 통과한 레코드 수, 기대치를 통과하지 못한 레코드 수와 같은 정보를 추출하는 데 적합한 프로그래밍 방식을 결정하십시오.
Lakeflow 선언적 파이프라인 이벤트 로그에서 원하는 데이터 품질 지표를 가져오는 메서드는 무엇입니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 98
user_ltv라는 테이블은 여러 팀의 데이터 분석가들이 사용할 뷰를 생성하는 데 사용됩니다. 워크스페이스의 사용자들은 그룹으로 구성되어 있으며, 이러한 그룹은 ACL을 사용하여 데이터 접근 권한을 설정하는 데 사용됩니다.
user_ltv 테이블은 다음과 같은 스키마를 가지고 있습니다.
이메일 문자열, 나이 정수, 장기존존기간 정수
다음 뷰 정의가 실행됩니다.
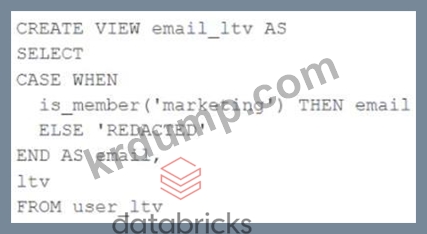
마케팅 그룹 소속이 아닌 분석가가 다음과 같은 쿼리를 실행합니다.
SELECT * FROM email_ltv
다음 중 이 쿼리의 결과를 가장 잘 설명하는 문장은 무엇입니까?
user_ltv 테이블은 다음과 같은 스키마를 가지고 있습니다.
이메일 문자열, 나이 정수, 장기존존기간 정수
다음 뷰 정의가 실행됩니다.
마케팅 그룹 소속이 아닌 분석가가 다음과 같은 쿼리를 실행합니다.
SELECT * FROM email_ltv
다음 중 이 쿼리의 결과를 가장 잘 설명하는 문장은 무엇입니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 99
프로덕션 환경에 구조화된 스트리밍 작업을 예약할 때, 쿼리 실패 시 자동으로 복구되고 비용을 낮게 유지하는 구성은 무엇입니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 100
데이터 엔지니어가 Databricks의 Jobs API를 사용하여 작업 모니터링 및 복구를 자동화하려고 합니다.
데이터 엔지니어는 모든 작업을 나열하고, 실패한 작업을 식별한 후 다시 실행해야 합니다. 이때 어떤 API 작업을 순서대로 수행해야 할까요?
데이터 엔지니어는 모든 작업을 나열하고, 실패한 작업을 식별한 후 다시 실행해야 합니다. 이때 어떤 API 작업을 순서대로 수행해야 할까요?