
Databricks-Certified-Professional-Data-Engineer 문제 166
상위 소스는 Parquet 데이터를 시간 단위로 현재 날짜로 명명된 디렉터리에 배치 형식으로 저장합니다. 야간 배치 작업은 다음 코드를 실행하여 date 변수에 지정된 날짜의 전날 데이터를 모두 수집합니다.
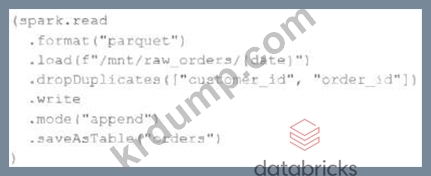
customer_id와 order_id 필드가 각 주문을 고유하게 식별하는 복합 키 역할을 한다고 가정합니다.
상위 시스템에서 단일 주문에 대해 몇 시간 간격으로 중복 항목이 생성되는 경우가 있는 것으로 알려져 있다면, 다음 중 어떤 설명이 맞습니까?
customer_id와 order_id 필드가 각 주문을 고유하게 식별하는 복합 키 역할을 한다고 가정합니다.
상위 시스템에서 단일 주문에 대해 몇 시간 간격으로 중복 항목이 생성되는 경우가 있는 것으로 알려져 있다면, 다음 중 어떤 설명이 맞습니까?
Databricks-Certified-Professional-Data-Engineer 문제 167
대규모 기업의 데이터 거버넌스 팀은 조직 전체의 데이터 검색 가능성을 개선하고자 합니다. 이 팀은 Databricks Lakehouse에 수백 개의 테이블과 수천 개의 열을 보유하고 있지만, 적절한 문서화가 되어 있지 않습니다. 이러한 테이블 중 상당수는 여러 팀에서 수년에 걸쳐 생성되었으며, 열의 의미와 비즈니스 로직에 대한 맥락 정보가 부족합니다. 데이터 거버넌스 팀은 규정 준수 요건을 충족하고 조직 전체의 데이터 활용 능력을 향상시키기 위해 기존 모든 테이블에 대한 포괄적인 열 설명을 신속하게 생성해야 합니다. 각 열을 수동으로 문서화하는 데 수개월이 소요될 것으로 예상되는 기존 방식 대신, 최신 기능을 활용하여 의미 있는 설명을 자동으로 생성하고자 합니다.
Databricks에서 기존 테이블의 열 주석 및 설명을 자동으로 생성하려면 어떤 접근 방식을 사용해야 할까요?
Databricks에서 기존 테이블의 열 주석 및 설명을 자동으로 생성하려면 어떤 접근 방식을 사용해야 할까요?
Databricks-Certified-Professional-Data-Engineer 문제 168
E1과 E2가 두 사건일 때, E1이 발생했을 경우 E2가 발생할 조건부 확률을 어떻게 나타낼 수 있을까요?
E1이 발생했습니까?
E1이 발생했습니까?
Databricks-Certified-Professional-Data-Engineer 문제 169
데이터 엔지니어가 인터넷 연결이 끊긴 Databricks 환경에 PyYAML Python 패키지를 설치해야 합니다. 해당 워크스페이스는 PyPI에 직접 접속할 수 없습니다. 엔지니어는 .whl 파일을 로컬에 다운로드했으며, 새로 생성되는 모든 클러스터에서 해당 패키지를 자동으로 사용할 수 있도록 하고 싶어합니다.
데이터 엔지니어는 어떤 접근 방식을 사용해야 할까요?
데이터 엔지니어는 어떤 접근 방식을 사용해야 할까요?
Databricks-Certified-Professional-Data-Engineer 문제 170
다음 중 사용자의 접근 권한에 따라 Delta 테이블의 행과 열에 대한 세밀한 접근 제어를 구현하는 데 사용할 수 있는 기술은 무엇입니까?