
Databricks-Certified-Professional-Data-Engineer 문제 181
아래의 각 구성은 클러스터당 총 400GB의 RAM, 총 160개의 코어, 그리고 VM당 하나의 Executor만 갖는다는 점에서 동일합니다.
하나 이상의 광범위한 변환이 포함된 작업이 주어졌을 때, 다음 클러스터 구성 중 어떤 구성이 최대 성능을 가져올까요?
하나 이상의 광범위한 변환이 포함된 작업이 주어졌을 때, 다음 클러스터 구성 중 어떤 구성이 최대 성능을 가져올까요?
Databricks-Certified-Professional-Data-Engineer 문제 182
데이터 엔지니어가 늦게 도착하는 중복 레코드를 처리할 가능성이 있는 파이프라인을 구성하고 있습니다.
배치 내에서 레코드 중복을 제거하는 것 외에도, 다음 중 어떤 접근 방식을 사용하면 데이터 엔지니어가 델타 테이블에 데이터를 삽입할 때 이전에 처리된 레코드와 중복된 데이터를 제거할 수 있습니까?
배치 내에서 레코드 중복을 제거하는 것 외에도, 다음 중 어떤 접근 방식을 사용하면 데이터 엔지니어가 델타 테이블에 데이터를 삽입할 때 이전에 처리된 레코드와 중복된 데이터를 제거할 수 있습니까?
Databricks-Certified-Professional-Data-Engineer 문제 183
데이터 엔지니어링 팀은 Delta Lake 테이블의 값을 모니터링하기 위해 Databricks SQL 쿼리와 알림을 구성했습니다. recent_sensor_recordings 테이블에는 최근 5분 동안의 기록에 대한 센서 ID, 타임스탬프 및 온도가 포함되어 있습니다.
아래 쿼리는 알림을 생성하는 데 사용됩니다.
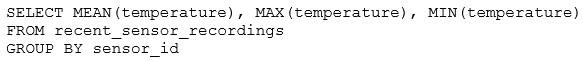
해당 쿼리는 1분마다 갱신되도록 설정되어 있으며 항상 10초 이내에 완료됩니다. 평균 온도(온도)가 120°F(섭씨 약 38도)를 초과하면 알림이 발생하도록 설정되어 있습니다. 알림은 최대 1분 간격으로 전송됩니다.
이 알림이 3분 동안 연속으로 발생하다가 멈춘다면, 다음 중 어떤 설명이 반드시 참이어야 합니까?
아래 쿼리는 알림을 생성하는 데 사용됩니다.
해당 쿼리는 1분마다 갱신되도록 설정되어 있으며 항상 10초 이내에 완료됩니다. 평균 온도(온도)가 120°F(섭씨 약 38도)를 초과하면 알림이 발생하도록 설정되어 있습니다. 알림은 최대 1분 간격으로 전송됩니다.
이 알림이 3분 동안 연속으로 발생하다가 멈춘다면, 다음 중 어떤 설명이 반드시 참이어야 합니까?
Databricks-Certified-Professional-Data-Engineer 문제 184
DLT 파이프라인에는 다음과 같은 스트리밍 테이블이 포함됩니다.
Raw_lot은 심박수 추적 장치에서 원시 장치 측정 데이터를 수집합니다.
Bgm_stats는 raw_lot의 BPM 측정값을 기반으로 사용자 통계를 점진적으로 계산합니다.
데이터 엔지니어는 파이프라인 업데이트 실행 시 하위 테이블을 다시 계산하는 동안 raw_iot 테이블에서 수동으로 삭제되거나 업데이트된 레코드를 유지할 수 있도록 이 파이프라인을 어떻게 구성해야 할까요?
Raw_lot은 심박수 추적 장치에서 원시 장치 측정 데이터를 수집합니다.
Bgm_stats는 raw_lot의 BPM 측정값을 기반으로 사용자 통계를 점진적으로 계산합니다.
데이터 엔지니어는 파이프라인 업데이트 실행 시 하위 테이블을 다시 계산하는 동안 raw_iot 테이블에서 수동으로 삭제되거나 업데이트된 레코드를 유지할 수 있도록 이 파이프라인을 어떻게 구성해야 할까요?
Databricks-Certified-Professional-Data-Engineer 문제 185
신입 데이터 엔지니어에게 DataFrame df를 사용하여 그룹화된 집계를 수행하는 스트리밍 데이터 파이프라인을 개발하라는 요청이 있었습니다. 이 파이프라인은 겹치지 않는 5분 간격으로 평균 습도와 평균 온도를 계산해야 합니다. 또한, 늦게 도착하는 데이터에 대해서는 10분 동안 증분 상태 정보를 유지해야 합니다.
스트리밍 데이터프레임 df는 다음과 같은 스키마를 가지고 있습니다.
"장치 ID INT, 이벤트 시간 TIMESTAMP, 온도 FLOAT, 습도 FLOAT"
코드 블록:

이 과제를 완료하려면 코드 블록 안의 빈칸을 올바르게 채우는 답을 선택하세요.
스트리밍 데이터프레임 df는 다음과 같은 스키마를 가지고 있습니다.
"장치 ID INT, 이벤트 시간 TIMESTAMP, 온도 FLOAT, 습도 FLOAT"
코드 블록:
이 과제를 완료하려면 코드 블록 안의 빈칸을 올바르게 채우는 답을 선택하세요.