DP-203-KR 문제 36
Azure Databricks를 사용할 스트리밍 데이터 솔루션을 계획하고 있습니다. 이 솔루션은 온라인 상점에서 판매 트랜잭션 데이터를 스트리밍합니다. 이 솔루션의 사양은 다음과 같습니다.
* 출력 데이터에는 구매한 품목, 수량, 라인 총 판매액, 라인 총 세액이 포함됩니다.
* 라인 총 판매 금액 및 라인 총 세금 금액은 Databricks에서 집계됩니다.
* 판매 거래는 절대 업데이트되지 않습니다. 대신 판매를 조정하기 위해 새 행이 추가됩니다.
Structured Streaming을 사용하여 처리할 데이터 세트에 대한 출력 모드를 권장해야 합니다. 솔루션은 중복 데이터를 최소화해야 합니다.
무엇을 추천해야 할까요?
* 출력 데이터에는 구매한 품목, 수량, 라인 총 판매액, 라인 총 세액이 포함됩니다.
* 라인 총 판매 금액 및 라인 총 세금 금액은 Databricks에서 집계됩니다.
* 판매 거래는 절대 업데이트되지 않습니다. 대신 판매를 조정하기 위해 새 행이 추가됩니다.
Structured Streaming을 사용하여 처리할 데이터 세트에 대한 출력 모드를 권장해야 합니다. 솔루션은 중복 데이터를 최소화해야 합니다.
무엇을 추천해야 할까요?
DP-203-KR 문제 37
표준 가격 책정 계층에 workspace1이라는 Azure Databricks 작업 영역이 있습니다.
다목적 클러스터 자동 확장을 지원하려면 workspace1을 구성해야 합니다. 솔루션은 다음 요구 사항을 충족해야 합니다.
클러스터가 3분 동안 충분히 활용되지 않으면 작업자를 자동으로 축소합니다.
최대 작업자 수로 확장하는 데 걸리는 시간을 최소화합니다.
비용을 최소화합니다.
먼저 무엇을 해야 합니까?
다목적 클러스터 자동 확장을 지원하려면 workspace1을 구성해야 합니다. 솔루션은 다음 요구 사항을 충족해야 합니다.
클러스터가 3분 동안 충분히 활용되지 않으면 작업자를 자동으로 축소합니다.
최대 작업자 수로 확장하는 데 걸리는 시간을 최소화합니다.
비용을 최소화합니다.
먼저 무엇을 해야 합니까?
DP-203-KR 문제 38
Azure Synapse Analytics 전용 SQL 풀이 포함된 Azure 구독이 있습니다.
병렬 쿼리의 단일 분포가 다른 분포보다 더 오래 걸리는지 확인해야 합니다.
병렬 쿼리의 단일 분포가 다른 분포보다 더 오래 걸리는지 확인해야 합니다.
DP-203-KR 문제 39
참고: 이 질문은 동일한 시나리오를 제시하는 일련의 질문 중 일부입니다. 시리즈의 각 질문에는 명시된 목표를 충족할 수 있는 고유한 솔루션이 포함되어 있습니다. 일부 질문 세트에는 하나 이상의 올바른 솔루션이 있을 수 있지만 다른 질문 세트에는 올바른 솔루션이 없을 수 있습니다.
이 섹션의 질문에 답한 후에는 해당 질문으로 돌아갈 수 없습니다. 결과적으로 이러한 질문은 검토 화면에 나타나지 않습니다.
Twitter 데이터를 분석할 Azure Stream Analytics 솔루션을 설계하고 있습니다.
각 10초 창에서 트윗 수를 계산해야 합니다. 솔루션은 각 트윗이 한 번만 계산되도록 해야 합니다.
솔루션: 10초의 홉 크기와 10초의 창 크기를 사용하는 호핑 창을 사용합니다.
이것이 목표를 달성합니까?
이 섹션의 질문에 답한 후에는 해당 질문으로 돌아갈 수 없습니다. 결과적으로 이러한 질문은 검토 화면에 나타나지 않습니다.
Twitter 데이터를 분석할 Azure Stream Analytics 솔루션을 설계하고 있습니다.
각 10초 창에서 트윗 수를 계산해야 합니다. 솔루션은 각 트윗이 한 번만 계산되도록 해야 합니다.
솔루션: 10초의 홉 크기와 10초의 창 크기를 사용하는 호핑 창을 사용합니다.
이것이 목표를 달성합니까?
DP-203-KR 문제 40
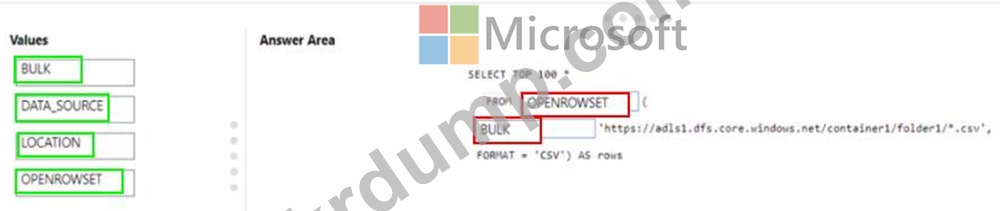
Azure Synapse Analytics 서버리스 SQ1 풀이 있습니다.
container1이라는 공용 컨테이너를 포함하는 aols1이라는 Azure Data Lake Storage 계정이 있습니다. 컨테이너 1 컨테이너에는 폴더 1이라는 폴더가 있습니다.
폴더 1에 있는 모든 CSV 파일의 상위 100개 행을 쿼리해야 합니다.
어떻게 shouk1 쿼리를 완료합니까? 응답하려면 적절한 값을 올바른 대상으로 드래그하십시오. 각 값은 한 번, 두 번 이상 사용되거나 전혀 사용되지 않을 수 있습니다. 콘텐츠를 보려면 창 사이의 분할 막대를 끌거나 스크롤해야 할 수 있습니다.
참고 각 올바른 선택은 1점의 가치가 있습니다.