

DP-203-KR 문제 46
CSV 파일에서 데이터를 수집하고 지정된 데이터 유형으로 열을 캐스팅하고 Azure Synapse Analytics 전용 SQL 풀의 테이블에 데이터를 삽입하는 Azure Data Factory 데이터 흐름을 만들고 있습니다. CSV 파일에는 사용자 이름, 설명 및 날짜라는 열이 포함되어 있습니다.
데이터 흐름에는 이미 다음이 포함되어 있습니다.
* 소스 변환
* 적절한 데이터 유형을 설정하는 파생 열 변환
* 데이터를 풀에 배치하기 위한 싱크 변환
데이터 흐름이 다음 요구 사항을 충족하는지 확인해야 합니다.
* 모든 유효한 행은 대상 테이블에 기록되어야 합니다.
* 주석 열의 잘림 오류는 사전에 방지해야 합니다.
* 삽입 시 잘림 오류가 발생하는 주석 값을 포함하는 모든 행은 Blob 저장소의 파일에 기록되어야 합니다.
어떤 두 가지 작업을 수행해야 합니까? 각 정답은 솔루션의 일부를 나타냅니다. 참고: 각 올바른 선택은 1점의 가치가 있습니다.
DP-203-KR 문제 47
Azure Synapse Analytics 전용 SQL 풀의 팩트 테이블에 증분식으로 데이터를 로드하고 있습니다.
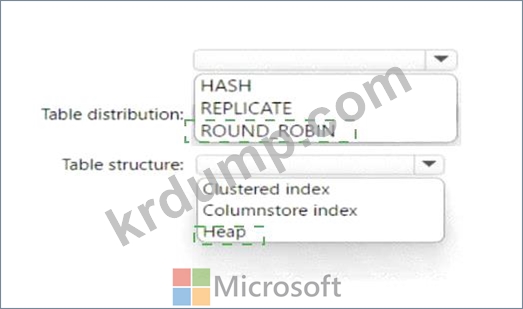
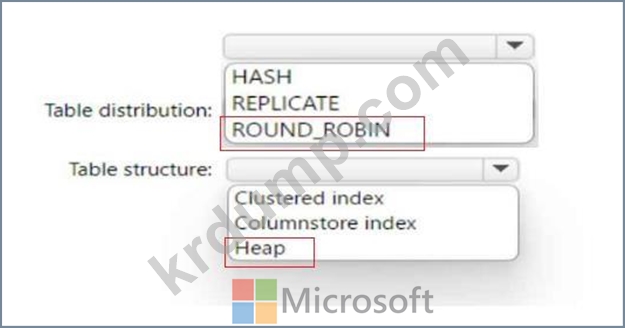
들어오는 데이터의 각 배치는 팩트 테이블에 로드되기 전에 준비됩니다. | 수신 데이터가 가능한 한 빨리 준비되었는지 확인해야 합니다. | 준비 테이블을 어떻게 구성해야 합니까? 대답하려면 대답 영역에서 적절한 옵션을 선택하십시오.
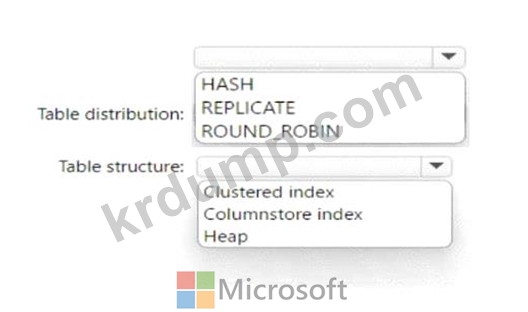
들어오는 데이터의 각 배치는 팩트 테이블에 로드되기 전에 준비됩니다. | 수신 데이터가 가능한 한 빨리 준비되었는지 확인해야 합니다. | 준비 테이블을 어떻게 구성해야 합니까? 대답하려면 대답 영역에서 적절한 옵션을 선택하십시오.
DP-203-KR 문제 48
Azure Synapse Analytics 전용 SQL 풀이 있습니다.
PDW_SHOWSPACEUSED(dbo,FactInternetSales')를 실행합니다. 다음 표에 표시된 결과를 얻습니다.

다음 중 dbo,FactInternetSales 테이블을 정확하게 설명하는 문장은 무엇입니까?
PDW_SHOWSPACEUSED(dbo,FactInternetSales')를 실행합니다. 다음 표에 표시된 결과를 얻습니다.
다음 중 dbo,FactInternetSales 테이블을 정확하게 설명하는 문장은 무엇입니까?
DP-203-KR 문제 49
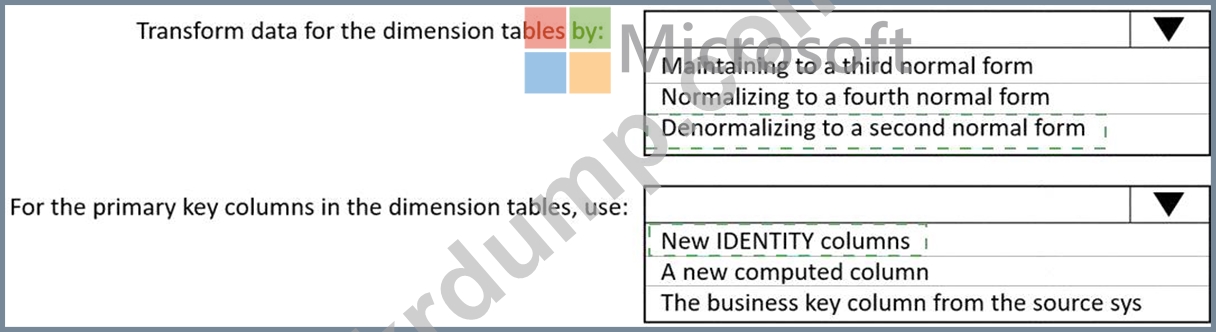
세 번째 정규 형식 스키마를 사용하는 Microsoft SQL Server 데이터베이스가 있습니다.
데이터베이스의 데이터를 Azure Synapse Analytics 전용 SQI 풀의 스타 스키마로 마이그레이션할 계획입니다.
차원 테이블을 설계해야 합니다. 솔루션은 읽기 작업을 최적화해야 합니다.
솔루션에 무엇을 포함해야 합니까? 대답하려면 대답 영역에서 적절한 옵션을 선택하십시오.
참고: 각 올바른 선택은 1점의 가치가 있습니다.
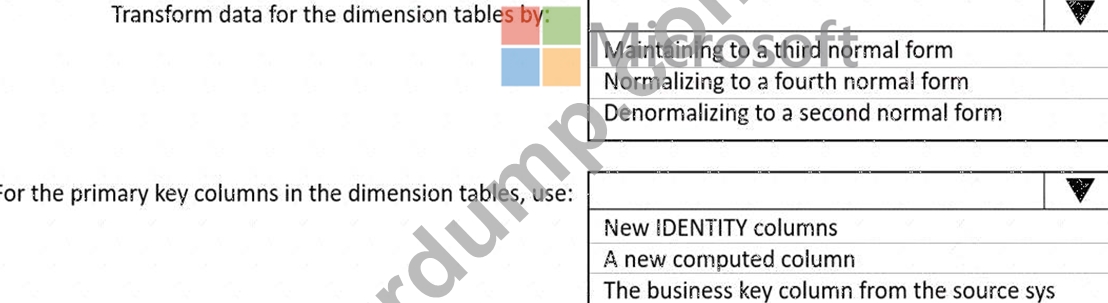
데이터베이스의 데이터를 Azure Synapse Analytics 전용 SQI 풀의 스타 스키마로 마이그레이션할 계획입니다.
차원 테이블을 설계해야 합니다. 솔루션은 읽기 작업을 최적화해야 합니다.
솔루션에 무엇을 포함해야 합니까? 대답하려면 대답 영역에서 적절한 옵션을 선택하십시오.
참고: 각 올바른 선택은 1점의 가치가 있습니다.


DP-203-KR 문제 50
Parquet 형식으로 배치 데이터 세트를 구현하고 있습니다.
데이터 타일은 Azure Data Factory를 사용하여 생성되고 Azure Data Lake Storage Gen2에 저장됩니다. 파일은 Azure Synapse Analytics 서버리스 SQL 풀에서 사용됩니다.
솔루션의 스토리지 비용을 최소화해야 합니다.
어떻게 해야 합니까?
데이터 타일은 Azure Data Factory를 사용하여 생성되고 Azure Data Lake Storage Gen2에 저장됩니다. 파일은 Azure Synapse Analytics 서버리스 SQL 풀에서 사용됩니다.
솔루션의 스토리지 비용을 최소화해야 합니다.
어떻게 해야 합니까?