
Databricks-Certified-Professional-Data-Engineer 문제 121
비즈니스 인텔리전스 팀은 소매 관련 기사에 대한 다양한 요약 지표를 추적하도록 구성된 대시보드를 보유하고 있습니다.
여기에는 전날 총 매출액과 다양한 기간별 총액 및 평균이 포함됩니다. 이 대시보드를 채우는 데 필요한 필드는 다음과 같은 스키마를 따릅니다.

수요 예측을 위해 레이크하우스는 모든 품목별 판매 내역이 포함된 검증된 테이블을 보유하고 있으며, 이 테이블은 거의 실시간으로 점진적으로 업데이트됩니다. products_per_order라는 이름의 이 테이블에는 다음과 같은 필드가 포함되어 있습니다.

장기 판매 추세 보고는 변동성이 적기 때문에 새로운 대시보드를 사용하는 분석가는 하루에 한 번만 데이터를 새로 고치면 됩니다. 또한, 일반적인 업무 시간 동안 많은 사용자가 대시보드를 대화형으로 조회하므로 결과가 빠르게 표시되고 각 데이터 생성에 필요한 총 컴퓨팅 리소스가 줄어듭니다.
어떤 솔루션이 최종 사용자의 기대를 충족시키면서 동시에 발생 가능한 비용을 통제하고 제한할 수 있을까요?
여기에는 전날 총 매출액과 다양한 기간별 총액 및 평균이 포함됩니다. 이 대시보드를 채우는 데 필요한 필드는 다음과 같은 스키마를 따릅니다.
수요 예측을 위해 레이크하우스는 모든 품목별 판매 내역이 포함된 검증된 테이블을 보유하고 있으며, 이 테이블은 거의 실시간으로 점진적으로 업데이트됩니다. products_per_order라는 이름의 이 테이블에는 다음과 같은 필드가 포함되어 있습니다.
장기 판매 추세 보고는 변동성이 적기 때문에 새로운 대시보드를 사용하는 분석가는 하루에 한 번만 데이터를 새로 고치면 됩니다. 또한, 일반적인 업무 시간 동안 많은 사용자가 대시보드를 대화형으로 조회하므로 결과가 빠르게 표시되고 각 데이터 생성에 필요한 총 컴퓨팅 리소스가 줄어듭니다.
어떤 솔루션이 최종 사용자의 기대를 충족시키면서 동시에 발생 가능한 비용을 통제하고 제한할 수 있을까요?
Databricks-Certified-Professional-Data-Engineer 문제 122
야간 작업은 다음 코드를 사용하여 Delta Lake 테이블에 데이터를 수집합니다.
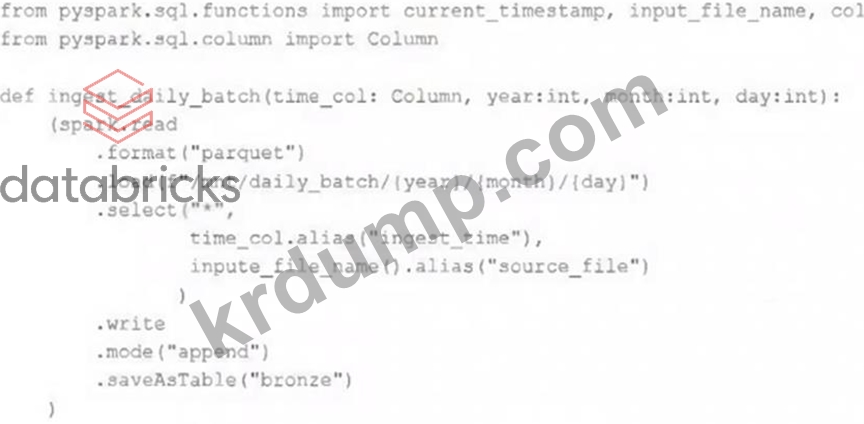
파이프라인의 다음 단계에서는 파이프라인의 다음 테이블로 아직 처리되지 않은 새 레코드를 조작하는 데 사용할 수 있는 객체를 반환하는 함수가 필요합니다.
다음 코드 조각 중 어떤 것이 이 함수 정의를 완성합니까?
def new_records():
파이프라인의 다음 단계에서는 파이프라인의 다음 테이블로 아직 처리되지 않은 새 레코드를 조작하는 데 사용할 수 있는 객체를 반환하는 함수가 필요합니다.
다음 코드 조각 중 어떤 것이 이 함수 정의를 완성합니까?
def new_records():
Databricks-Certified-Professional-Data-Engineer 문제 123
두 개의 노트북을 정해진 스케줄에 따라 실행하도록 설정하려고 합니다. 두 번째 노트북은 첫 번째 노트북에 종속되지만, 두 노트북 모두 최적의 성능을 발휘하기 위해 서로 다른 유형의 컴퓨팅 리소스가 필요합니다. 이러한 노트북들을 작업으로 설정하는 가장 좋은 방법은 무엇일까요?
Databricks-Certified-Professional-Data-Engineer 문제 124
데이터 엔지니어가 분석 팀에서 사용할 트랜잭션 델타 테이블을 Databricks에 생성했습니다. 분석 팀은 해당 테이블을 Apache Iceberg 형식을 필요로 하는 다른 도구와 함께 사용하려고 합니다.
데이터 엔지니어는 무엇을 해야 할까요?
데이터 엔지니어는 무엇을 해야 할까요?
Databricks-Certified-Professional-Data-Engineer 문제 125
현재 Spark Stream 프로세스를 사용하여 일회성 마이크로 배치 작업을 위해 데이터를 읽고 쓰는 동시에 기존 대상 테이블을 수정하는 작업을 진행 중입니다. 아래 명령어를 성공적으로 완료하려면 빈칸을 채우세요.
1.spark.table("source_table")
2..writeStream
3..옵션("____", "dbfs:/location/silver")
4..outputMode("____")
5..트리거(한 번=____)
6..table("target_table")
1.spark.table("source_table")
2..writeStream
3..옵션("____", "dbfs:/location/silver")
4..outputMode("____")
5..트리거(한 번=____)
6..table("target_table")