
Databricks-Certified-Professional-Data-Engineer 문제 91
프로덕션 환경에 배포된 구조화된 스트리밍 작업이 하루 중 사용량이 많은 시간대에 지연 현상을 보이고 있습니다. 현재 정상적인 실행 시에는 각 마이크로배치 데이터 처리 시간이 3초 미만입니다. 하지만 사용량이 많은 시간대에는 각 마이크로배치의 처리 시간이 매우 불규칙해지며, 때로는 30초를 초과하기도 합니다. 현재 스트리밍 쓰기 작업은 10초 간격으로 트리거되도록 설정되어 있습니다.
다른 모든 변수를 일정하게 유지하고 레코드를 10초 이내에 처리해야 한다고 가정할 때, 어떤 조정이 요구 사항을 충족할까요?
다른 모든 변수를 일정하게 유지하고 레코드를 10초 이내에 처리해야 한다고 가정할 때, 어떤 조정이 요구 사항을 충족할까요?
Databricks-Certified-Professional-Data-Engineer 문제 92
user_ltv라는 테이블은 여러 팀의 데이터 분석가들이 사용할 뷰를 생성하는 데 사용됩니다. 워크스페이스의 사용자들은 그룹으로 구성되어 있으며, 이러한 그룹은 ACL을 사용하여 데이터 접근 권한을 설정하는 데 사용됩니다.
user_ltv 테이블은 다음과 같은 스키마를 가지고 있습니다.
이메일 문자열, 나이 정수, 장기 고객 기간 정수
다음 뷰 정의가 실행됩니다.
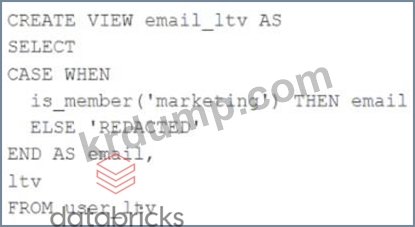
마케팅 그룹 소속이 아닌 분석가가 다음과 같은 쿼리를 실행합니다.
SELECT * FROM email_ltv
다음 중 이 쿼리의 결과를 가장 잘 설명하는 문장은 무엇입니까?
user_ltv 테이블은 다음과 같은 스키마를 가지고 있습니다.
이메일 문자열, 나이 정수, 장기 고객 기간 정수
다음 뷰 정의가 실행됩니다.
마케팅 그룹 소속이 아닌 분석가가 다음과 같은 쿼리를 실행합니다.
SELECT * FROM email_ltv
다음 중 이 쿼리의 결과를 가장 잘 설명하는 문장은 무엇입니까?
Databricks-Certified-Professional-Data-Engineer 문제 93
데이터 엔지니어가 데이터 소스에서 스트리밍 읽기를 수행하는 코드 블록을 개발했습니다. 해당 코드 블록은 다음과 같습니다.
아래에:
1. (스파크)
2. 읽기
3. .스키마(스키마)
4. .format("cloudFiles")
5. .option("cloudFiles.format", "json")
6. .load(dataSource)
7.)
해당 코드 블록에서 오류가 발생했습니다.
코드 블록이 성공적으로 작동하도록 구성하려면 다음 중 어떤 변경 사항을 코드 블록에 적용해야 합니까?
스트리밍 읽기를 수행하시겠습니까?
아래에:
1. (스파크)
2. 읽기
3. .스키마(스키마)
4. .format("cloudFiles")
5. .option("cloudFiles.format", "json")
6. .load(dataSource)
7.)
해당 코드 블록에서 오류가 발생했습니다.
코드 블록이 성공적으로 작동하도록 구성하려면 다음 중 어떤 변경 사항을 코드 블록에 적용해야 합니까?
스트리밍 읽기를 수행하시겠습니까?
Databricks-Certified-Professional-Data-Engineer 문제 94
다음 표는 전자상거래 웹사이트에서 사용자가 장바구니에 담는 상품들을 보여줍니다.

다음 MERGE 문은 스키마 평가가 활성화된 이 테이블을 업데이트 뷰를 사용하여 업데이트하는 데 사용됩니다.

다음 업데이트는 어떻게 처리해야 할까요?
다음 MERGE 문은 스키마 평가가 활성화된 이 테이블을 업데이트 뷰를 사용하여 업데이트하는 데 사용됩니다.
다음 업데이트는 어떻게 처리해야 할까요?
Databricks-Certified-Professional-Data-Engineer 문제 95
Lakeflow 선언적 파이프라인의 운영 측면은 Spark 구조적 스트리밍과 어떻게 다른가요?