
Databricks-Certified-Data-Engineer-Professional-KR 문제 36
데이터 엔지니어링 팀은 다음 코드를 유지 관리합니다.

이 코드가 논리적으로 올바른 결과를 생성하고 원본 테이블의 데이터가 중복 제거 및 유효성 검사를 거쳤다고 가정할 때, 이 코드가 실행될 때 발생하는 상황을 설명하는 문장은 무엇입니까?
이 코드가 논리적으로 올바른 결과를 생성하고 원본 테이블의 데이터가 중복 제거 및 유효성 검사를 거쳤다고 가정할 때, 이 코드가 실행될 때 발생하는 상황을 설명하는 문장은 무엇입니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 37
데이터 엔지니어가 Lakeflow Spark Declarative Pipelines를 사용하여 고객 데이터 파이프라인을 구축하고 있습니다. 소스는 고객 레코드의 삽입, 업데이트 및 삭제 정보를 포함하는 클라우드 기반 이벤트 스트림이며, 데이터 보존 기간이 제한되어 있습니다. 이러한 변경 사항은 `AUTO CDC INTO` 구문을 사용하여 적용되며, 대상 테이블은 `customer_dim`이라는 SCD Type 1 테이블로 유지됩니다. 데이터 엔지니어는 `customer_dim` 테이블에서 데이터를 스트리밍하여 업데이트 및 삭제 이벤트만 처리하고 데이터를 점진적으로 처리하는 다운스트림 작업을 어떻게 구축해야 할까요?
Databricks-Certified-Data-Engineer-Professional-KR 문제 38
데이터 엔지니어 팀은 새로운 데이터 파이프라인으로 마이그레이션을 시작하기 전에 개발, 테스트 및 프로덕션 환경을 구성하고 있습니다. 팀은 코드 실행 결과로 생성되는 코드와 데이터 모두에 대한 광범위한 테스트가 필요하며, 가능한 한 실제 운영 환경과 유사한 데이터를 사용하여 개발 및 테스트를 진행하고자 합니다.
신입 데이터 엔지니어가 프로덕션 데이터를 개발 테스트 환경에 마운트하여 프로덕션 전 코드가 프로덕션 데이터를 대상으로 실행될 수 있도록 하자고 제안했습니다. 개발 환경에서는 모든 사용자가 관리자 권한을 가지고 있으므로, 해당 엔지니어는 팀을 위해 권한을 설정하고 데이터를 마운트하는 작업을 직접 수행하겠다고 했습니다.
다음 중 이 상황에 대한 최적의 방안을 나타내는 진술은 무엇입니까?
신입 데이터 엔지니어가 프로덕션 데이터를 개발 테스트 환경에 마운트하여 프로덕션 전 코드가 프로덕션 데이터를 대상으로 실행될 수 있도록 하자고 제안했습니다. 개발 환경에서는 모든 사용자가 관리자 권한을 가지고 있으므로, 해당 엔지니어는 팀을 위해 권한을 설정하고 데이터를 마운트하는 작업을 직접 수행하겠다고 했습니다.
다음 중 이 상황에 대한 최적의 방안을 나타내는 진술은 무엇입니까?
Databricks-Certified-Data-Engineer-Professional-KR 문제 39
데이터 엔지니어링 팀의 한 구성원이 더 큰 데이터 파이프라인의 일부로 실행되도록 예약하려는 간단한 노트북 파일을 제출했습니다. 아래 제공된 명령어를 제시된 대로 실행하면 논리적으로 올바른 결과가 생성된다고 가정합니다.
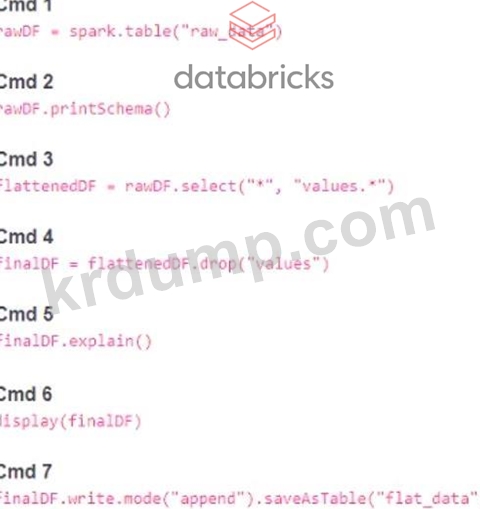
노트북을 작업으로 예약하기 전에 어떤 명령어를 제거해야 할까요?
노트북을 작업으로 예약하기 전에 어떤 명령어를 제거해야 할까요?
Databricks-Certified-Data-Engineer-Professional-KR 문제 40
뷰 업데이트는 고객 테이블에 삽입 또는 업데이트될 모든 새로 수집된 데이터의 증분 배치를 나타냅니다.
이러한 기록을 처리하는 데에는 다음과 같은 논리가 사용됩니다.
고객과 합병하세요
사용 (
SELECT updates.customer_id as merge_ey, updates .*
업데이트에서
유니온 올
merge_key로 NULL을 선택하고 업데이트를 실행합니다.
업데이트에서 참여하세요
ON updates.customer_id = customers.customer_id
WHERE customers.current = true AND updates.address <> customers.address ) staged_updates ON customers.customer_id = mergekey WHEN MATCHED AND customers.current = true AND customers.address <> staged_updates.address THEN UPDATE SET current = false, end_date = staged_updates.effective_date WHEN NOT MATCHED THEN INSERT (customer_id, address, current, effective_date, end_date) VALUES (staged_updates.customer_id, staged_updates.address, true, staged_updates.effective_date, null) 이 구현을 설명하는 문장은 무엇입니까?
이러한 기록을 처리하는 데에는 다음과 같은 논리가 사용됩니다.
고객과 합병하세요
사용 (
SELECT updates.customer_id as merge_ey, updates .*
업데이트에서
유니온 올
merge_key로 NULL을 선택하고 업데이트를 실행합니다.
업데이트에서 참여하세요
ON updates.customer_id = customers.customer_id
WHERE customers.current = true AND updates.address <> customers.address ) staged_updates ON customers.customer_id = mergekey WHEN MATCHED AND customers.current = true AND customers.address <> staged_updates.address THEN UPDATE SET current = false, end_date = staged_updates.effective_date WHEN NOT MATCHED THEN INSERT (customer_id, address, current, effective_date, end_date) VALUES (staged_updates.customer_id, staged_updates.address, true, staged_updates.effective_date, null) 이 구현을 설명하는 문장은 무엇입니까?
프리미엄 번들
DumpTop 에서 공유하는 최신 Databricks-Certified-Data-Engineer-Professional-KR 시험 덤프는 Databricks-Certified-Data-Engineer-Professional-KR 시험패스를 도와드릴수 있습니다! DumpTop 은 최근 업데이트된 Databricks-Certified-Data-Engineer-Professional-KR 시험자료를 제공해드립니다. DumpTop Databricks-Certified-Data-Engineer-Professional-KR 덤프도 시험문제 변경에 따라 업데이트되었으며 오답도 수정되었습니다. DumpTop Databricks-Certified-Data-Engineer-Professional-KR 덤프 최신버전을 공유받아보세요.
(250 Q&As 덤프, 30%OFF할인코드: KrDump)