
DY0-001 문제 26
k-평균 모델에서 k는 다음 중 무엇을 나타냅니까?
DY0-001 문제 27
한 팀이 스팸 탐지 시스템을 개발 중입니다. 이 팀은 복잡하고 심층적인 과거 데이터셋 학습 없이 확률 기반의 식별 방법을 원합니다. 다음 중 어떤 방법이 이러한 목적에 가장 적합할까요?
DY0-001 문제 28
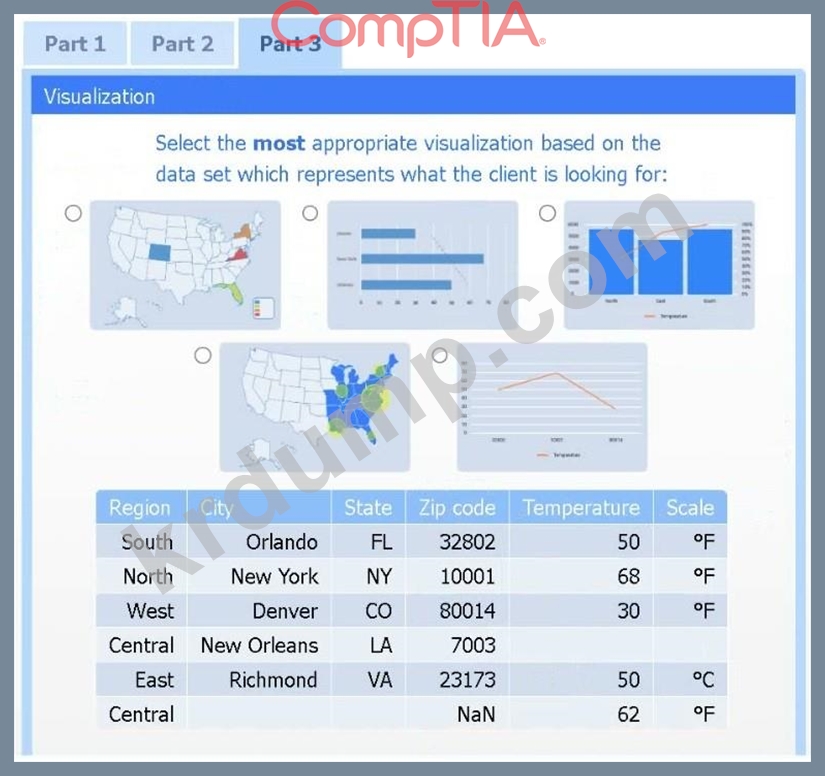
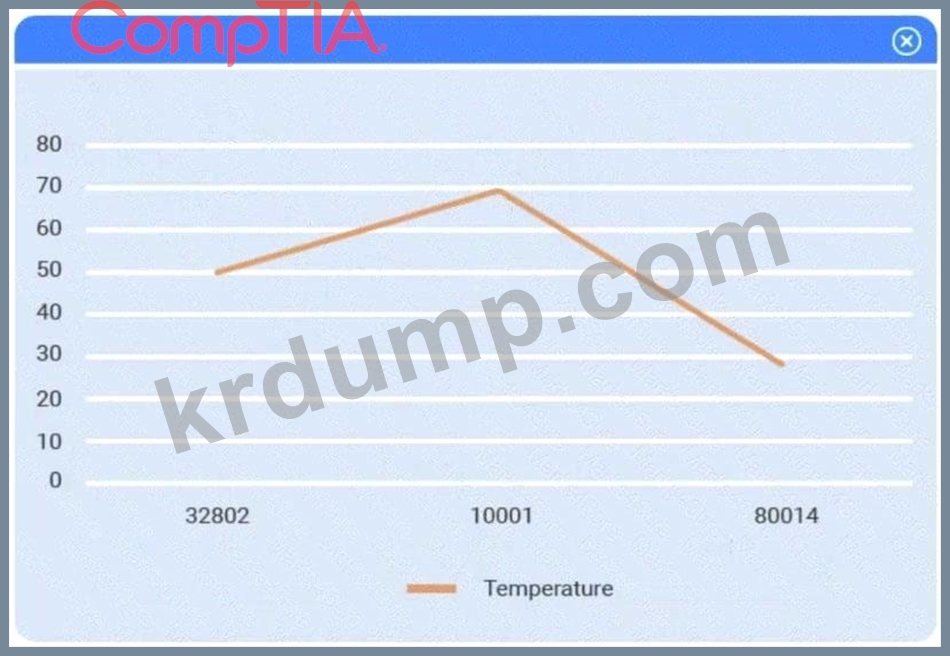
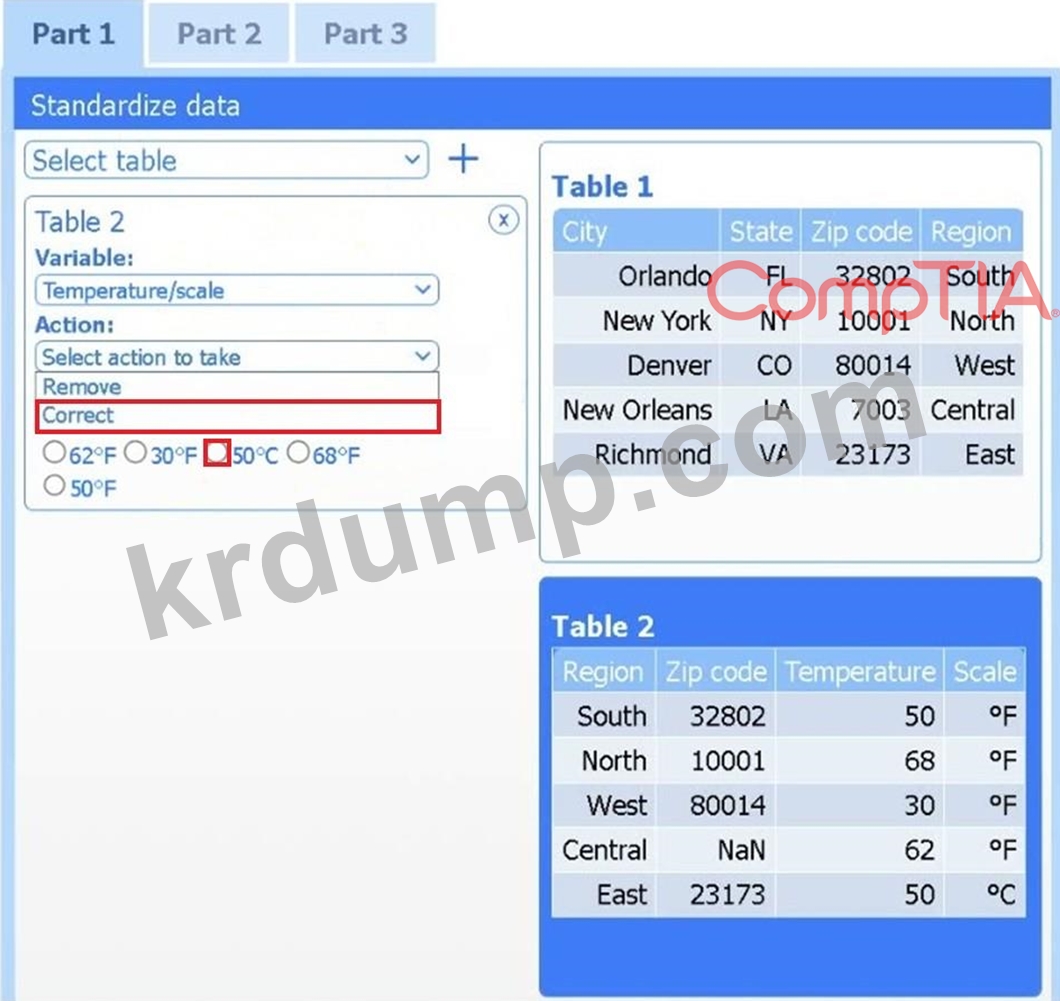
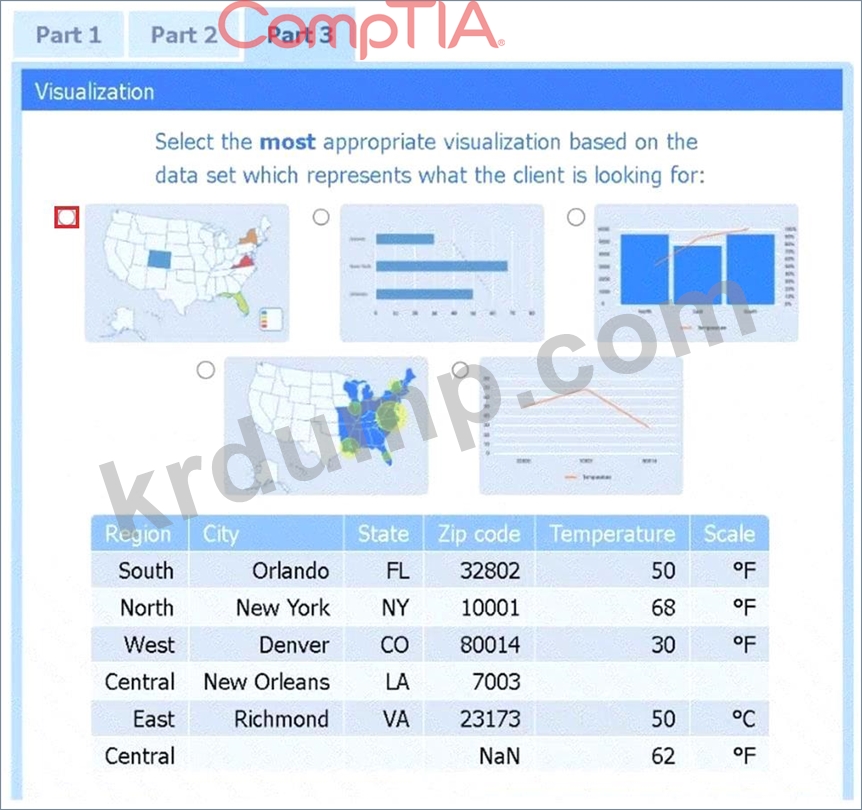
의뢰인은 고온 현상이 나타나는 지역에 대한 기상 데이터를 수집했습니다. 의뢰인은 이 데이터를 더 잘 이해할 수 있도록 시각화 자료를 원합니다.
지침
파트 1
제공된 차트를 검토하고 드롭다운 메뉴를 사용하여 데이터를 표준화하는 가장 적절한 방법을 선택하십시오.
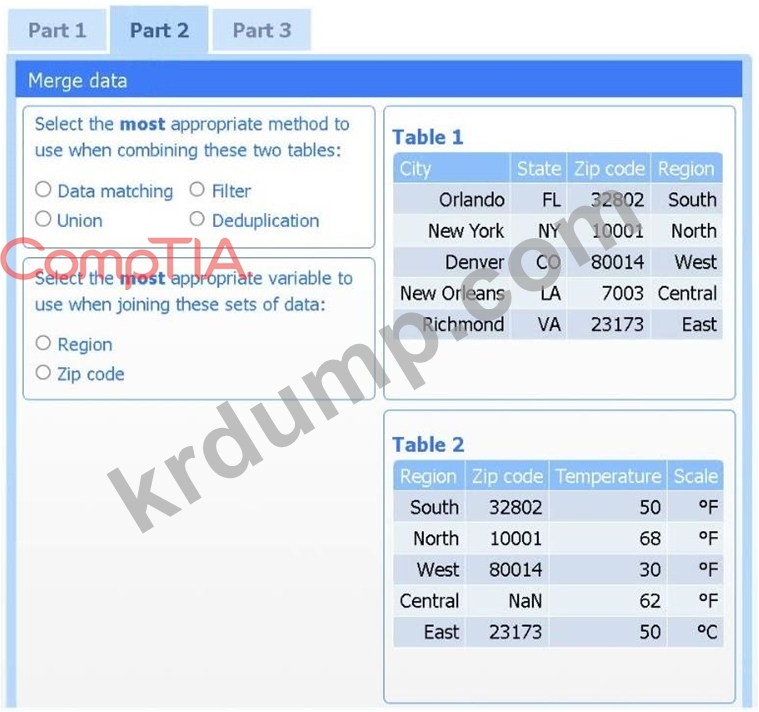
파트 2
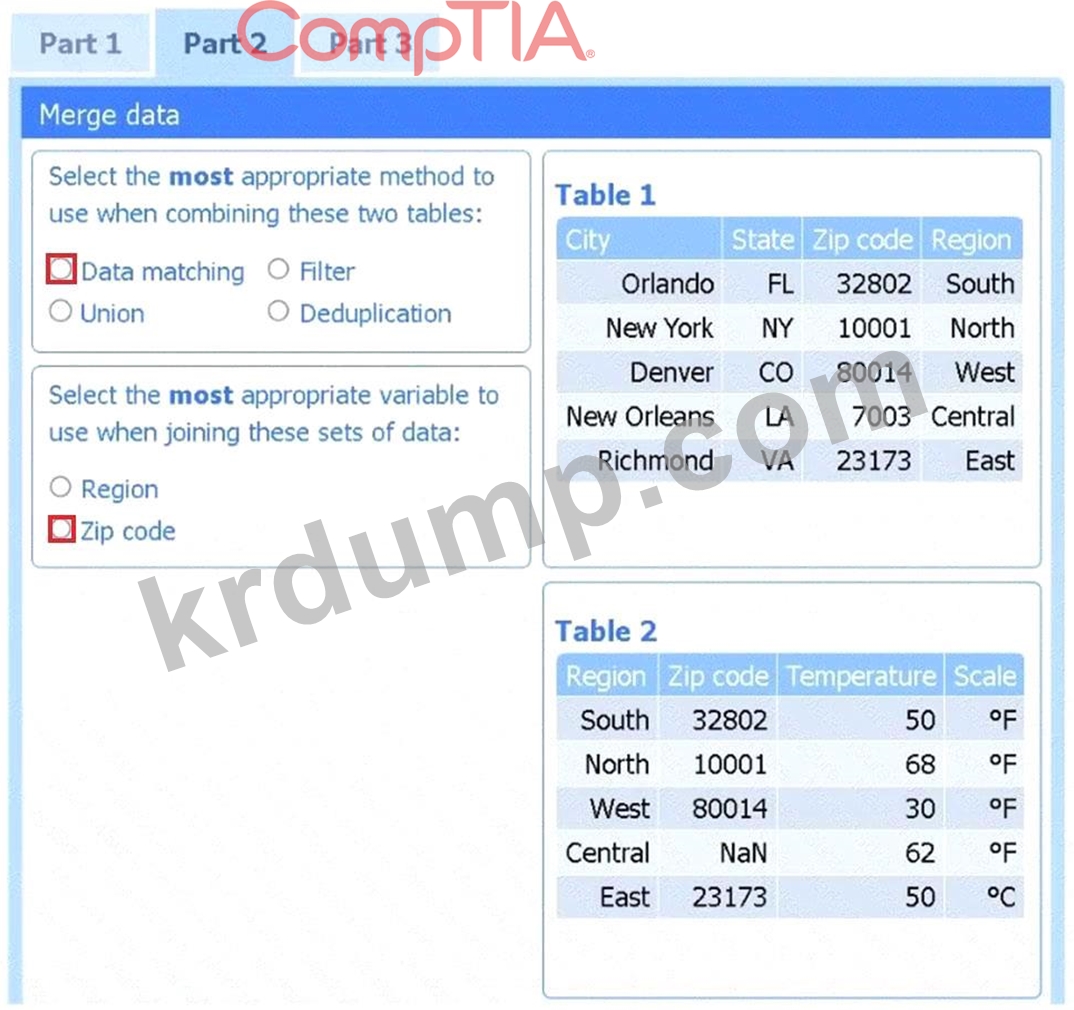
다음 질문에 답하여 하나의 데이터 세트를 만드는 방법을 알아보세요.
파트 3
고객이 원하는 바를 가장 잘 나타내는 시각화 방식을 데이터 세트를 기반으로 선택하십시오.
시뮬레이션을 초기 상태로 되돌리려면 언제든지 '모두 초기화' 버튼을 클릭하십시오.
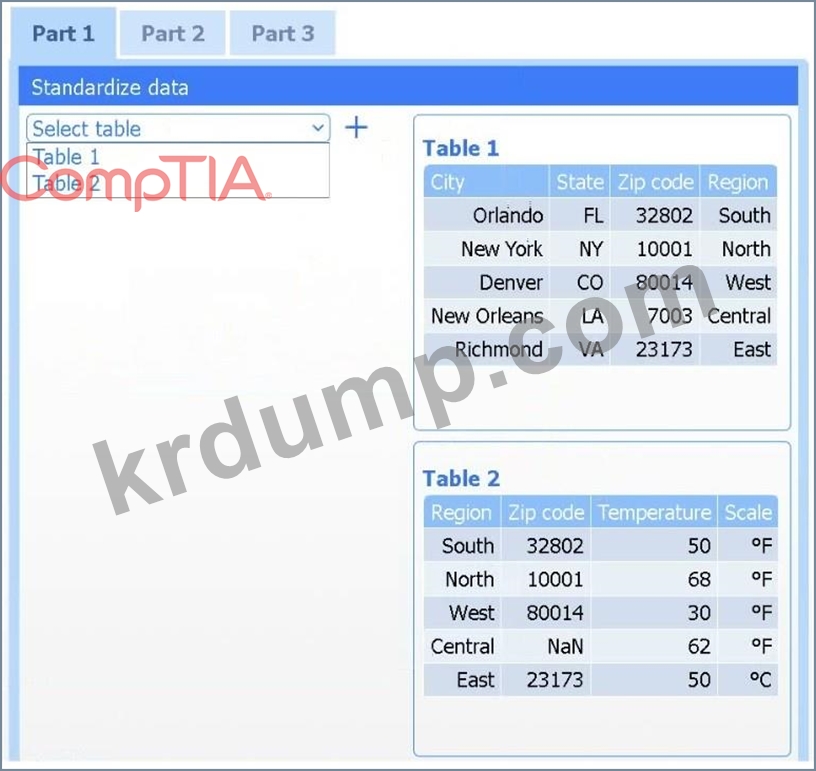

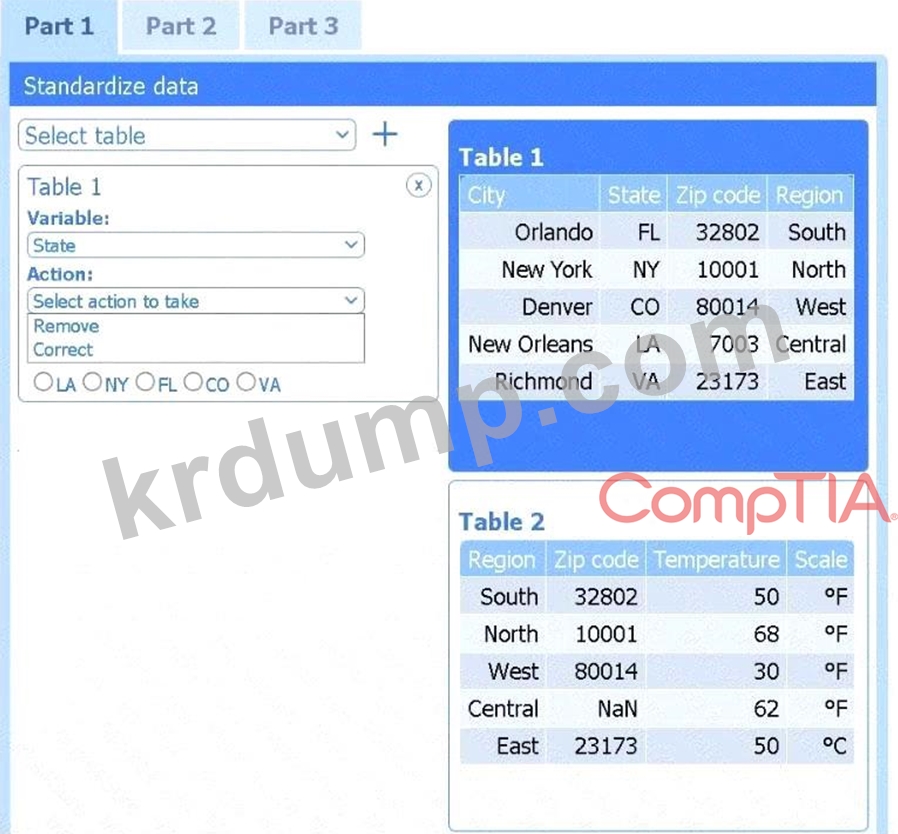
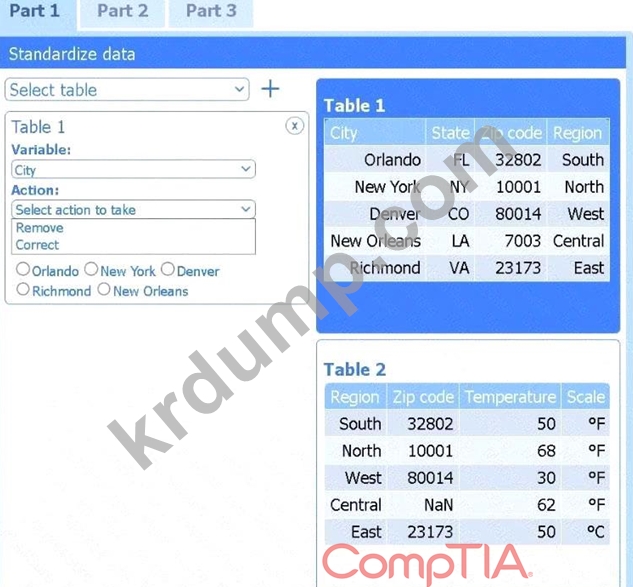
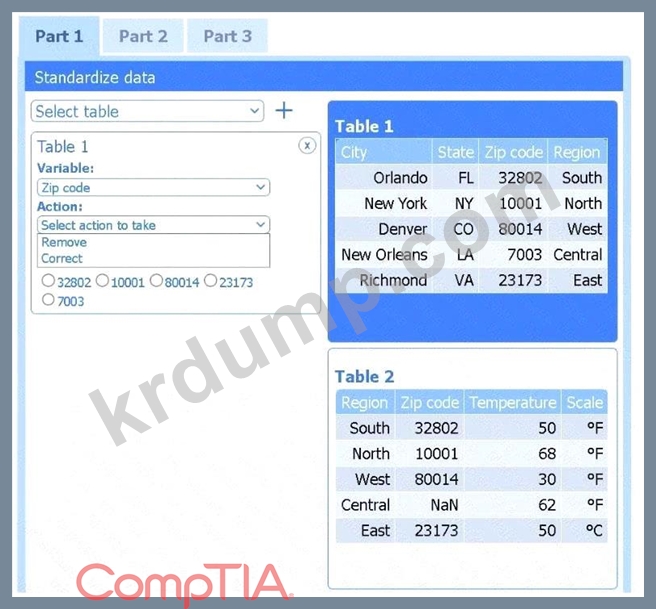
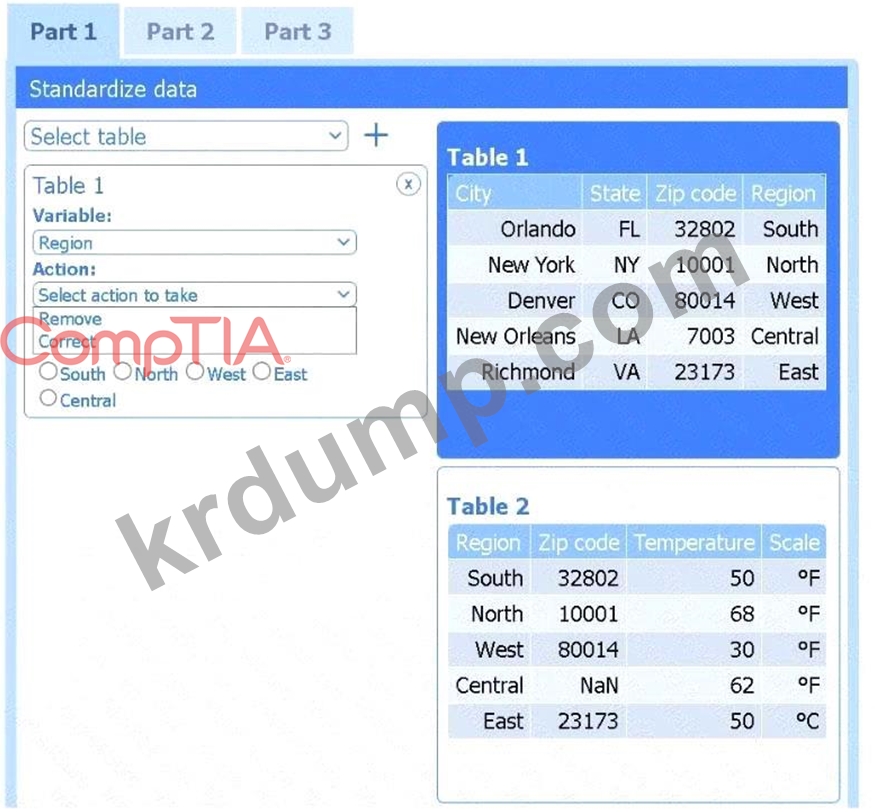
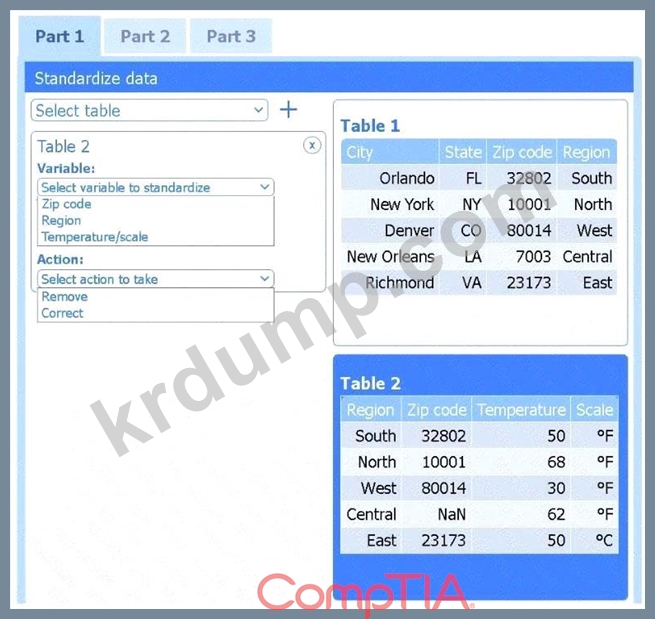
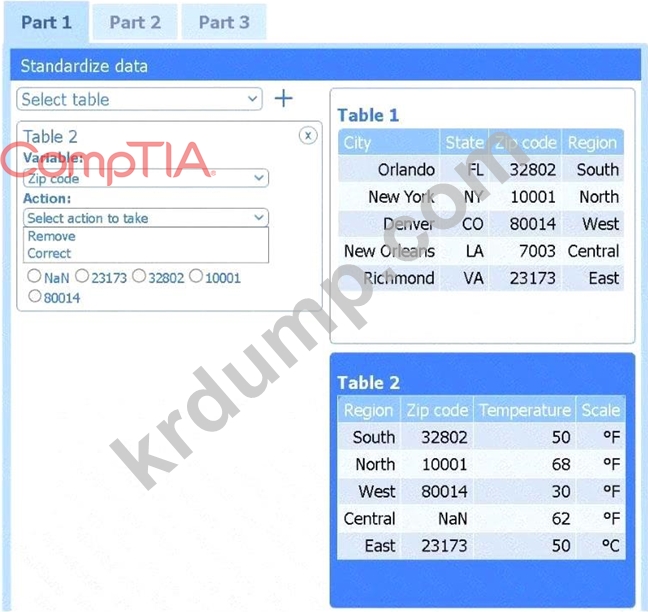
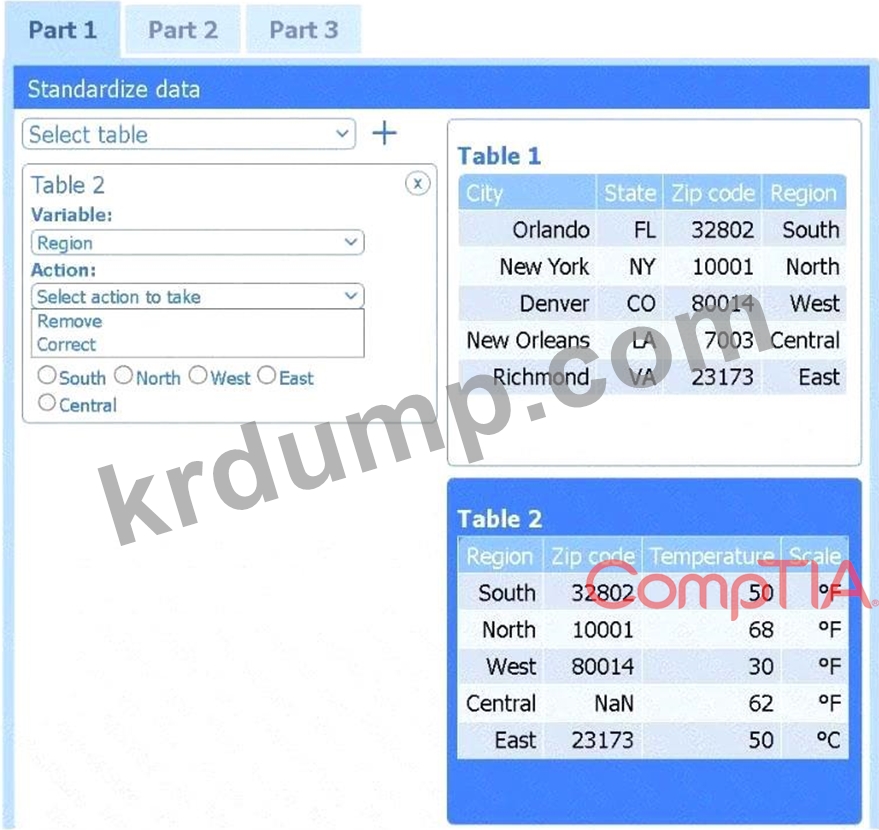
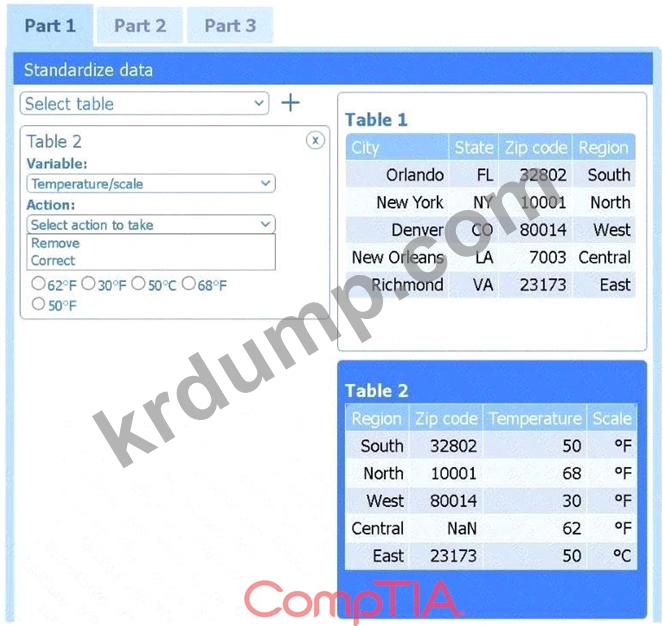
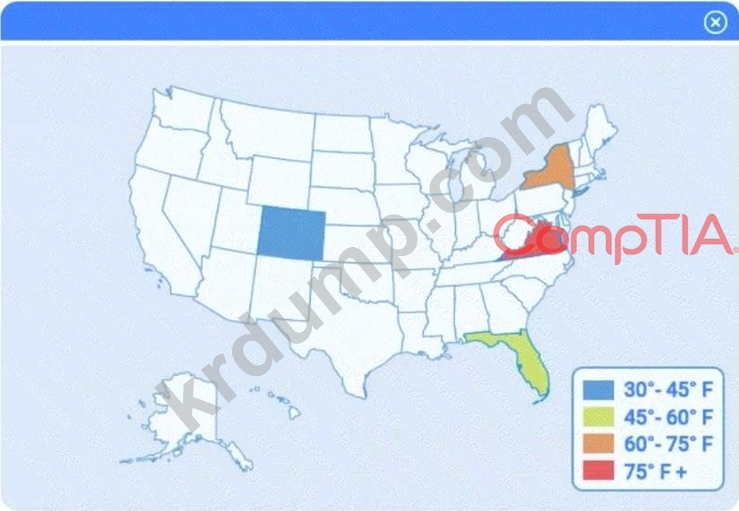
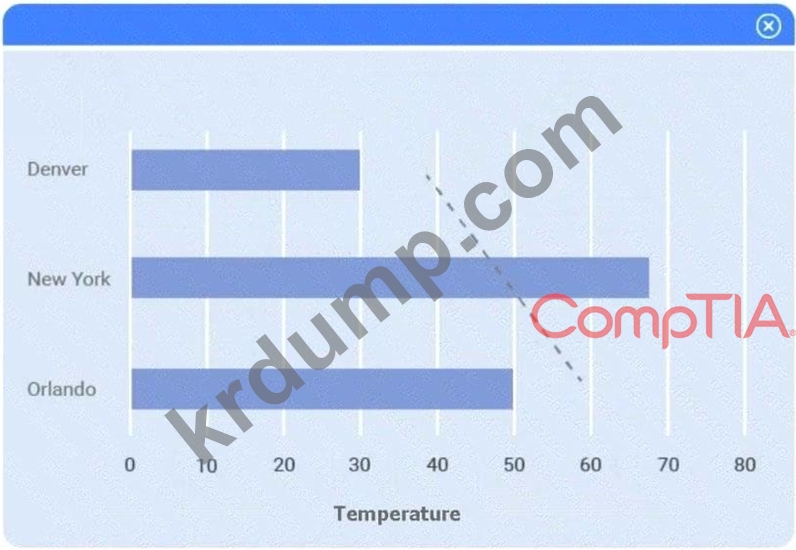
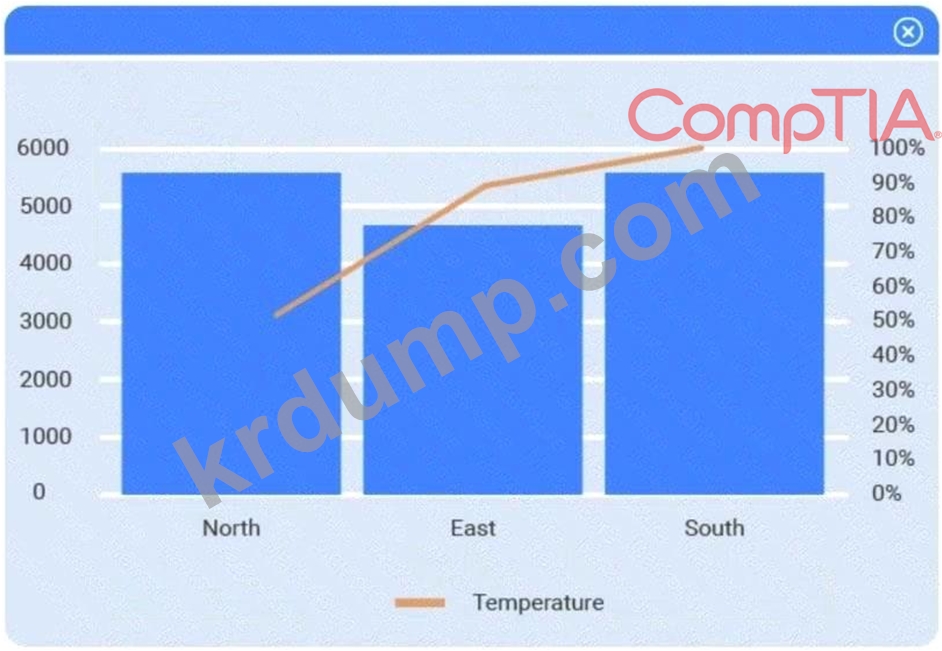
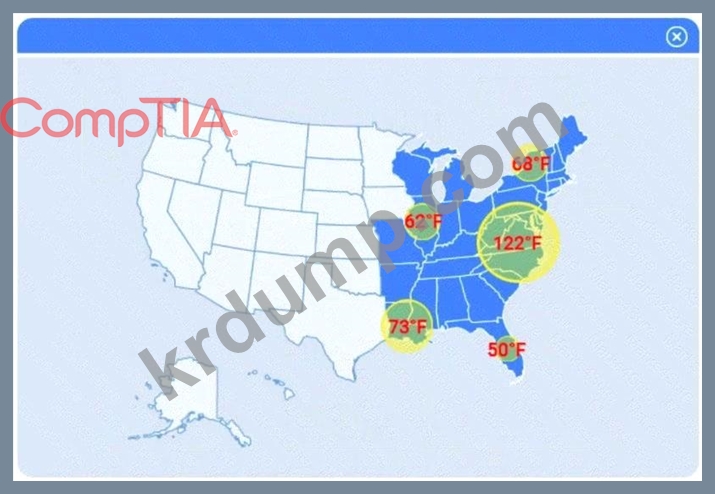
지침
파트 1
제공된 차트를 검토하고 드롭다운 메뉴를 사용하여 데이터를 표준화하는 가장 적절한 방법을 선택하십시오.
파트 2
다음 질문에 답하여 하나의 데이터 세트를 만드는 방법을 알아보세요.
파트 3
고객이 원하는 바를 가장 잘 나타내는 시각화 방식을 데이터 세트를 기반으로 선택하십시오.
시뮬레이션을 초기 상태로 되돌리려면 언제든지 '모두 초기화' 버튼을 클릭하십시오.
DY0-001 문제 29
데이터 과학자가 범주형 특징을 가진 데이터 세트를 분석하고 있으며, 모델 구축에 있어 이러한 특징들을 더욱 유용하게 만들고자 합니다. 다음 중 데이터 과학자가 사용해야 할 데이터 변환 기법은 무엇일까요? (두 가지를 선택하세요.)
DY0-001 문제 30
데이터 과학자는 범주형, 이산형, 연속형 변수로 구성된 대규모 데이터 세트를 사용하여 복잡한 현상을 모델링하고자 합니다. 탐색적 데이터 분석을 완료한 후, 데이터 과학자는 예측 변수와 목표 변수 사이에 선형 관계가 존재하지 않는다는 것을 상당히 확신합니다. 비록 현상이 복잡하지만, 데이터 과학자는 최종 모델에서 최대한 높은 수준의 해석 가능성을 유지하고자 합니다. 다음 알고리즘 중 이 목표를 가장 잘 충족하는 것은 무엇일까요?