

DP-203-KR 문제 141
온도라는 Apache Spark DataFrame이 있습니다. 데이터 샘플은 다음 표에 나와 있습니다.
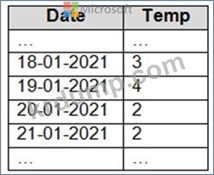
Spark SQL 쿼리를 사용하여 다음 테이블을 생성해야 합니다.

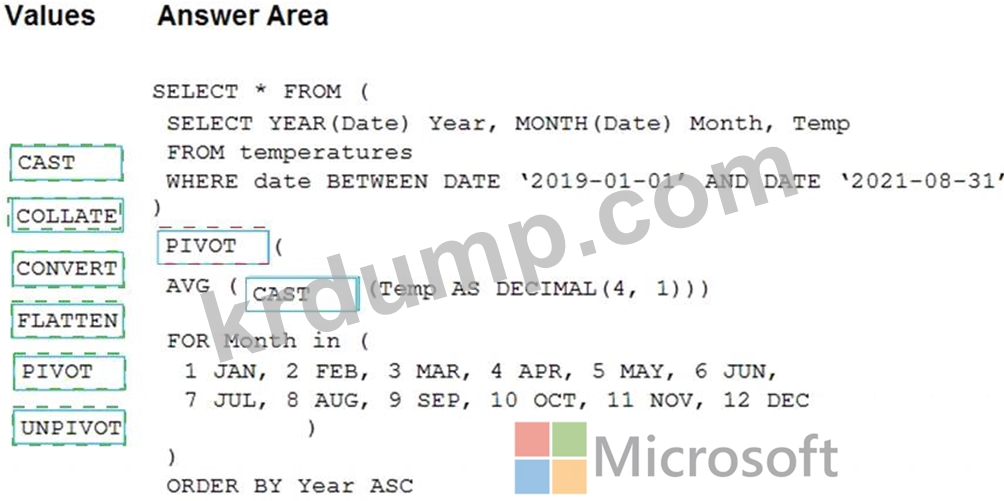
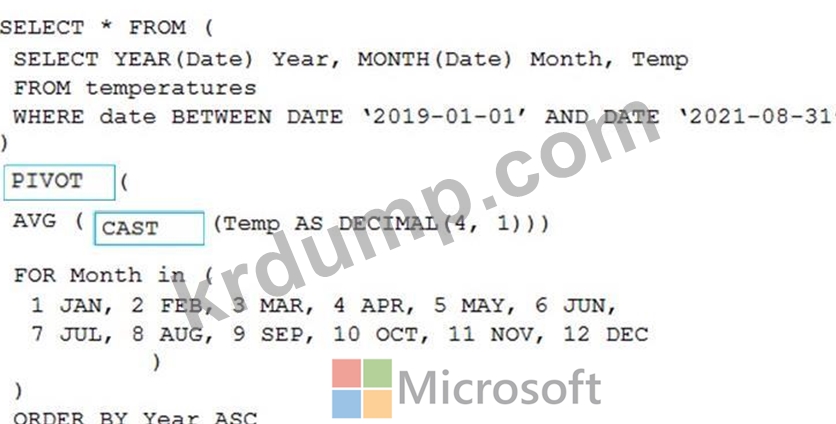
쿼리를 어떻게 완료해야 합니까? 응답하려면 적절한 값을 올바른 대상으로 드래그하십시오. 각 값은 한 번, 두 번 이상 사용되거나 전혀 사용되지 않을 수 있습니다. 콘텐츠를 보려면 창 사이의 분할 막대를 끌거나 스크롤해야 할 수 있습니다.
참고: 각 올바른 선택은 1점의 가치가 있습니다.
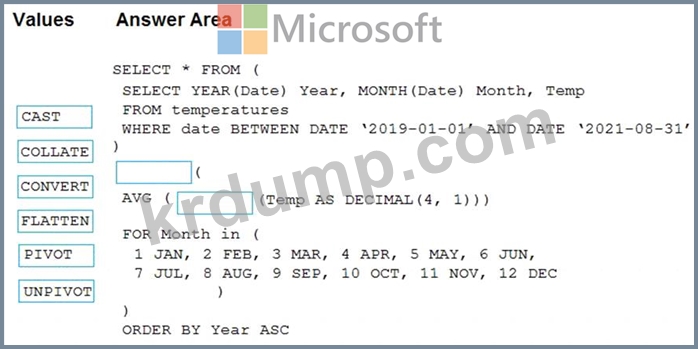
Spark SQL 쿼리를 사용하여 다음 테이블을 생성해야 합니다.
쿼리를 어떻게 완료해야 합니까? 응답하려면 적절한 값을 올바른 대상으로 드래그하십시오. 각 값은 한 번, 두 번 이상 사용되거나 전혀 사용되지 않을 수 있습니다. 콘텐츠를 보려면 창 사이의 분할 막대를 끌거나 스크롤해야 할 수 있습니다.
참고: 각 올바른 선택은 1점의 가치가 있습니다.
DP-203-KR 문제 142
ADF1이라는 Azure 데이터 팩터리가 있습니다.
현재 모든 파이프라인 제작 변경 사항을 ADF1에 직접 게시합니다.
파이프라인 아티팩트의 변경 사항에 대한 버전 제어를 구현해야 합니다. 솔루션은 ADF1에 대한 UX 제작 캔버스에 현재 정의된 리소스에 버전 제어를 적용할 수 있도록 보장해야 합니다.
어떤 두 가지 작업을 수행해야 합니까? 각 정답은 솔루션의 일부를 나타냅니다. 참고: 각 정답은 1점의 가치가 있습니다.
현재 모든 파이프라인 제작 변경 사항을 ADF1에 직접 게시합니다.
파이프라인 아티팩트의 변경 사항에 대한 버전 제어를 구현해야 합니다. 솔루션은 ADF1에 대한 UX 제작 캔버스에 현재 정의된 리소스에 버전 제어를 적용할 수 있도록 보장해야 합니다.
어떤 두 가지 작업을 수행해야 합니까? 각 정답은 솔루션의 일부를 나타냅니다. 참고: 각 정답은 1점의 가치가 있습니다.
DP-203-KR 문제 143
작업 영역이라는 Azure Databricks 작업 영역이 있습니다! 표준 가격 책정 계층에서. Workspace1에는 cluster라는 다목적 클러스터가 포함되어 있습니다. 클러스터 1을 시작하고 확장하는 데 걸리는 시간을 줄여야 합니다. 솔루션은 비용을 최소화해야 합니다. 먼저 무엇을 해야 합니까?
DP-203-KR 문제 144
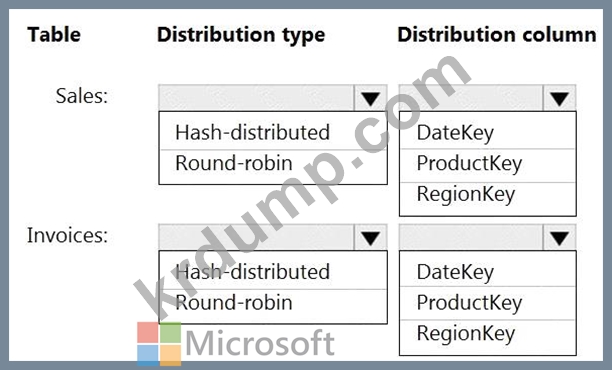
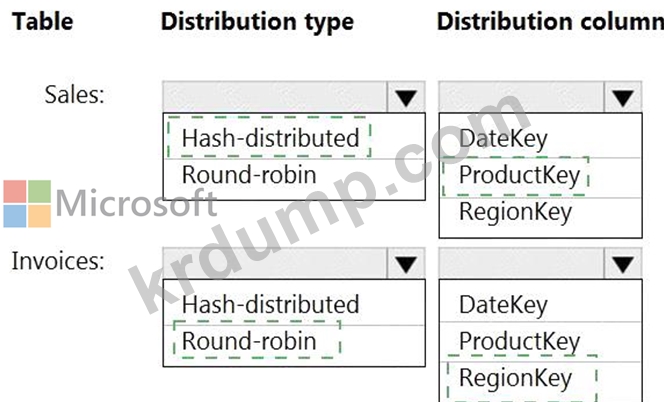
다음 팩트 테이블을 포함하는 온프레미스 데이터 웨어하우스가 있습니다. 두 테이블 모두 DateKey, ProductKey, RegionKey 열이 있습니다. 120개의 고유한 제품 키와 65개의 고유한 지역 키가 있습니다.

데이터 웨어하우스를 사용하는 쿼리는 완료하는 데 시간이 오래 걸립니다.
Azure Synapse Analytics를 사용하도록 솔루션을 마이그레이션할 계획입니다. Azure 기반 솔루션이 쿼리 성능을 최적화하고 처리 왜곡을 최소화하는지 확인해야 합니다.
무엇을 추천해야 할까요? 대답하려면 대답 영역에서 적절한 옵션을 선택하십시오.
참고: 각 올바른 선택은 1점의 가치가 있습니다.
데이터 웨어하우스를 사용하는 쿼리는 완료하는 데 시간이 오래 걸립니다.
Azure Synapse Analytics를 사용하도록 솔루션을 마이그레이션할 계획입니다. Azure 기반 솔루션이 쿼리 성능을 최적화하고 처리 왜곡을 최소화하는지 확인해야 합니다.
무엇을 추천해야 할까요? 대답하려면 대답 영역에서 적절한 옵션을 선택하십시오.
참고: 각 올바른 선택은 1점의 가치가 있습니다.

DP-203-KR 문제 145
Azure Synapse에 SQL 풀이 있습니다.
사용자가 풀에 대한 쿼리를 완료하는 데 예상보다 오래 걸린다고 보고합니다.
문제를 진단하는 데 도움이 되도록 기본 스토리지에 모니터링을 추가해야 합니다.
어떤 두 측정항목을 모니터링해야 합니까? 각 정답은 솔루션의 일부를 나타냅니다.
참고: 각 올바른 선택은 1점의 가치가 있습니다.
사용자가 풀에 대한 쿼리를 완료하는 데 예상보다 오래 걸린다고 보고합니다.
문제를 진단하는 데 도움이 되도록 기본 스토리지에 모니터링을 추가해야 합니다.
어떤 두 측정항목을 모니터링해야 합니까? 각 정답은 솔루션의 일부를 나타냅니다.
참고: 각 올바른 선택은 1점의 가치가 있습니다.